

n8n에서 JSON을 다루는 과정은, 외부 API로 받은 데이터를 실제 업무에 활용할 수 있는 형태로 바꾸는 데 있어 핵심이 된다. API 응답을 받아 보면 구조가 지나치게 복잡해, 원하는 필드만 쏙쏙 뽑아내기가 쉽지 않다. 배열이 여러 겹으로 중첩되면, 데이터 처리가 한순간에 꼬여버린 경험도 한두 번쯤 있을 것이다. 특히 n8n처럼 모든 과정을 시각적 워크플로우로 진행하는 도구에서 ‘코드 한 줄 없이’ 이 난관을 헤쳐 나가려면 더 막막해질 수밖에 없다.
실제로 JSON 처리를 하다 보면 가장 시간을 많이 허비하는 부분은 복잡한 코드 작성이 아니라, “내가 지금 보고 있는 값이 배열인지 객체인지”, “다음 노드로 넘길 때 아이템 개수가 정확히 맞는지” 헷갈리는 순간이다. 겉으론 값이 잘 나오는 듯 보이다가도, 다음 노드에서 갑자기 undefined가 찍히거나 배열 전체가 쏟아져 들어오면서 로직이 통째로 틀어지는 경우가 적지 않다. n8n은 데이터가 아이템 단위로 흐르는 도구라, 처음에 JSON 구조 읽는 감각만 잘 익혀두면 이후 API 연동 난이도도 확실히 내려간다.
실패 패턴도 자주 반복된다. 첫 번째는 배열이 비어 있을 수 있다는 가능성을 놓치고 무심코 [0]으로 접근하는 것, 두 번째는 Set 노드에서 충분히 처리할 수 있는 일을 굳이 Function 노드로 넘겨 로직을 불필요하게 복잡하게 만드는 것, 세 번째는 중첩 필드 경로를 한 글자라도 틀려놓고선 데이터 구조 자체를 의심하며 오랜 시간을 헤매는 경우다. JSON 처리는 복잡하게 꼬는 것보다, 처음부터 구조를 정확히 확인하고 예외 가능성을 선제적으로 차단하는 습관이 더 중요하다.
💡 3줄 요약
- n8n에서 JSON을 다룰 때는 Set 노드, Function 노드, 그리고 표현식 이 세 가지 도구를 조합해 원하는 형태로 데이터를 가공한다.
- 복잡하게 중첩된 JSON 구조는 점 표기법이나 $json, $item 같은 변수를 활용하면 한층 쉽게 접근할 수 있다.
- 가장 자주 실수하는 부분은 배열 인덱스 처리, 그리고 undefined 값을 미처 예외 처리하지 못하는 것이다. 이를 미리 대비하는 것이 성공의 열쇠다.
왜 n8n에서 JSON 처리가 어렵게 느껴질까?
많은 이들이 n8n으로 API 연동을 시작했다가, 생각보다 까다로운 JSON 구조 앞에서 손을 놓기 쉽다. 외부 서비스들이 반환하는 JSON은, 사람이 읽기 쉽게 만들어져 있지 않다. 꼭 필요한 데이터만 깔끔하게 오는 법은 드물고, 계층은 깊게 파묻혀 있으며, 심지어 필드명이 겹치는 일도 잦다.
이럴 때 단순히 ‘필드 이름만 알면 되지 않을까?’라고 생각하면, 원하는 값을 제대로 추출하지 못하는 경우가 많다. 결국 중요한 건 데이터 구조를 정확히 파악하고, 그 구조에 맞는 표현식을 직접 써 보는 것이다. n8n의 JSON 처리는 바로 이 지점에서 출발한다.
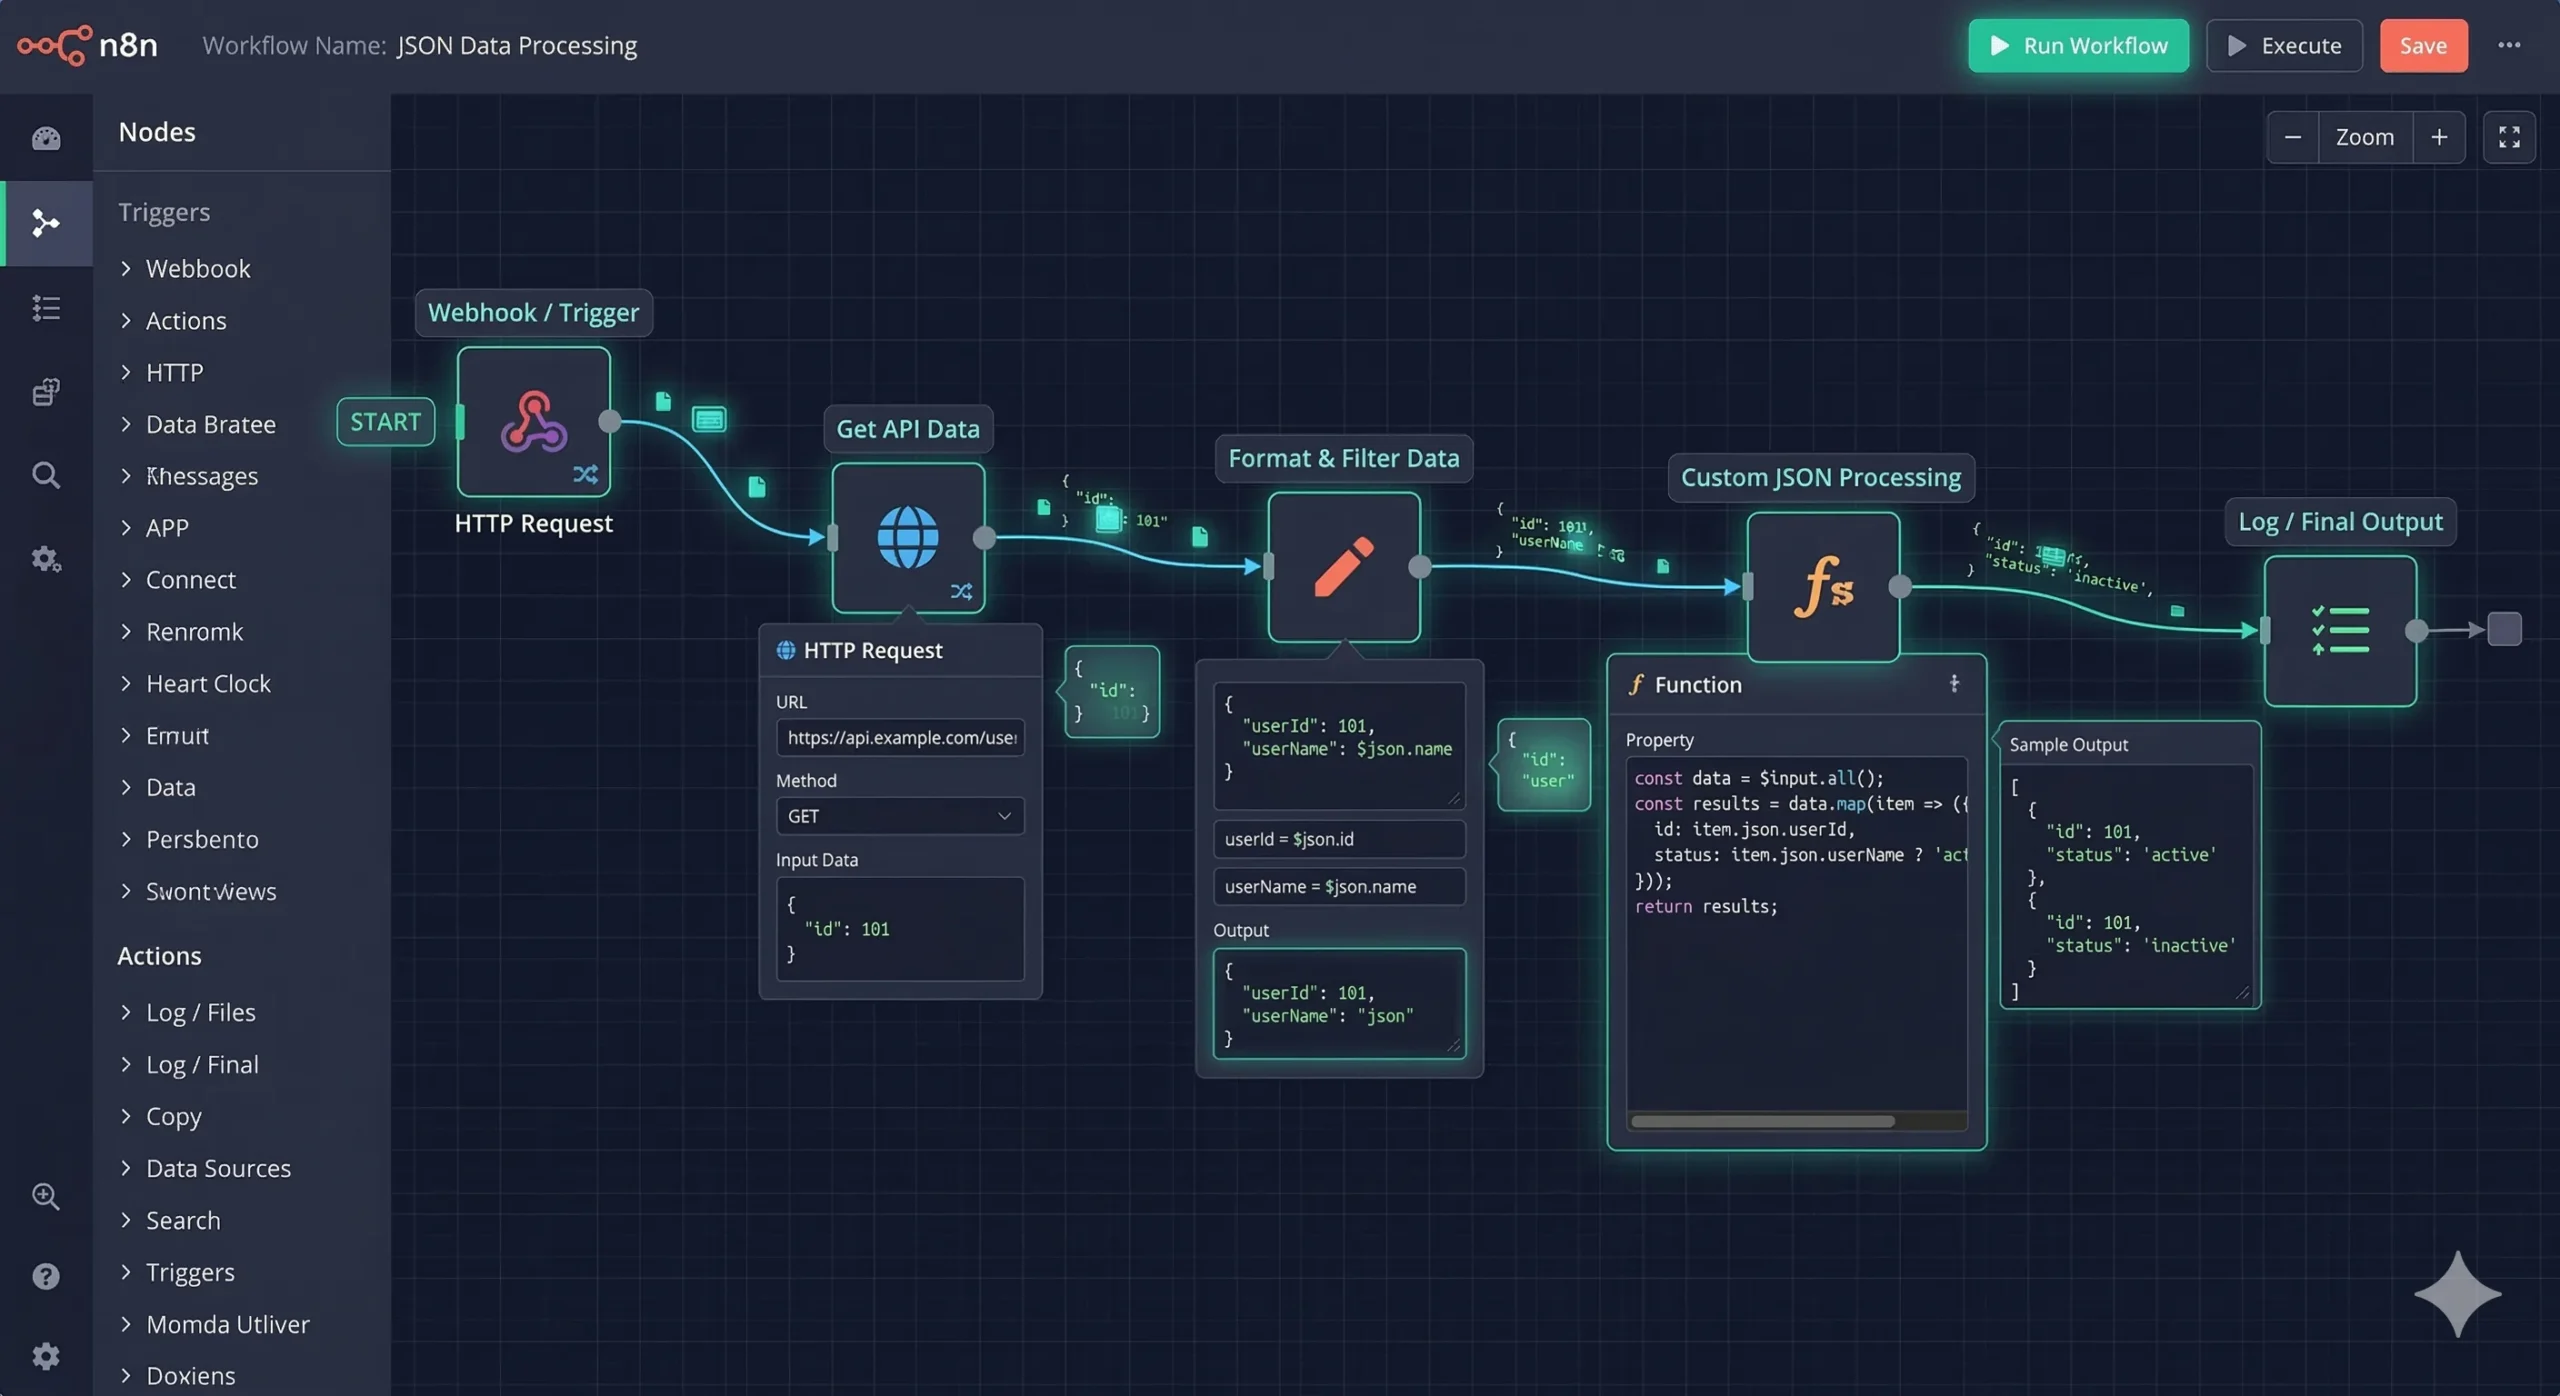
이 글은 n8n JSON 처리: 복잡한 API 응답을 깔끔하게 가공하는 법를 처음 적용하는 사람보다도, 이미 한두 번 시도해봤지만 설정 기준이 매번 헷갈렸던 사람에게 더 도움이 되도록 정리했다. 단순 기능 소개보다 실제로 어디서 막히는지, 무엇을 먼저 확인해야 덜 돌아가게 되는지에 초점을 맞췄다.
특히 이 주제는 비슷한 설명이 반복되는 경우가 많아 보이지만, 실제 작업에서는 환경과 목적에 따라 판단 기준이 달라진다. 그래서 아래 내용도 정답 하나를 밀어붙이기보다, 선택이 갈리는 지점을 중심으로 읽는 편이 훨씬 도움이 된다.
1. n8n JSON 처리의 기본 구조 이해하기
n8n에서 각 노드가 실행될 때마다 그 결과는 자동으로 JSON 객체 형태로 저장된다. 이 결과는 $json이라는 특수 변수를 통해 쉽게 참조할 수 있으며, 배열 안 특정 요소에 접근하려면 $item(“노드명”).json처럼 사용할 수 있다. 예를 들어 HTTP Request 노드로 받은 응답이 있을 때는 {{$json.body.users[0].name}}처럼 점 표기법을 이용하여 데이터의 깊숙한 값까지 파고들 수 있다.
하지만 여기서 반드시 유의해야 할 부분이 있다. 바로 배열의 인덱스를 잘못 지정하는 경우다. 예를 들어 users 배열이 비어 있다면 users[0]은 undefined가 되어, 관련된 나머지 데이터 처리 로직이 모두 실패하게 된다. 이런 상황을 방지하기 위해선 ??(null 병합 연산자)나 조건부 표현식을 함께 써 주는 습관이 필요하다.
웹훅이나 HTTP 요청으로 들어온 구조부터 먼저 익히고 싶다면 [관련 글: n8n 웹훅 설정 가이드 오류 없이 연결하는 법 더 알아보기], [관련 글: n8n HTTP 트리거노드 심화 설정 및 보안 실무 가이드 더 알아보기]를 같이 보면 JSON이 어디서부터 들어오고 어떻게 넘어오는지 감을 잡기 좋다.
2. Set 노드로 손쉽게 JSON 정제하기
Set 노드는 n8n에서 가장 직관적으로 JSON 데이터를 다룰 수 있는 도구다. 새로운 필드를 추가하거나 기존 필드를 재정의할 때 유용하게 쓰인다. 예를 들어 API 응답에 user.profile.full_name 필드가 있다면, Set 노드에서 name이라는 새 필드를 만들고 값에 {{$json.user.profile.full_name}}을 입력하면 원하는 데이터 변환이 가능하다.
이렇게 하면 복잡한 코드를 짜지 않아도 데이터를 손쉽게 ‘재포장’할 수 있어, n8n 입문자에게 매우 친절한 방식이다. 그러나, 만약 복잡한 조건 처리나 반복문 등이 필요하다면 Set 노드만으로는 한계가 분명하다. 이런 경우엔 Function 노드를 활용하는 것이 훨씬 유리하다.
| 노드 유형 | 적용 시나리오 |
|---|---|
| Set 노드 | 단순 필드 매핑, 이름 변경, 기본값 설정 |
| Function 노드 | 조건부 로직, 배열 반복, 복잡한 변환 |
이처럼 각 노드의 특성을 잘 이해하고 상황에 맞게 조합하면, n8n 안에서 데이터 흐름을 훨씬 유연하게 설계할 수 있다.
Set 노드 활용을 더 깊게 보고 싶다면 [관련 글: n8n Set 노드로 복잡한 데이터 필드 정리하는 완벽 가이드 더 알아보기]를 이어서 보면 필드 추가, 재정의, 중첩 객체 처리까지 바로 연결해서 이해할 수 있다.
n8n JSON 처리 실전 패턴 3가지
실무에서 자주 마주치는 JSON 구조에는 몇 가지 공통된 패턴이 존재한다. 이 패턴들을 미리 익혀두면, 실제 업무에서 훨씬 효율적으로 문제를 해결할 수 있다.
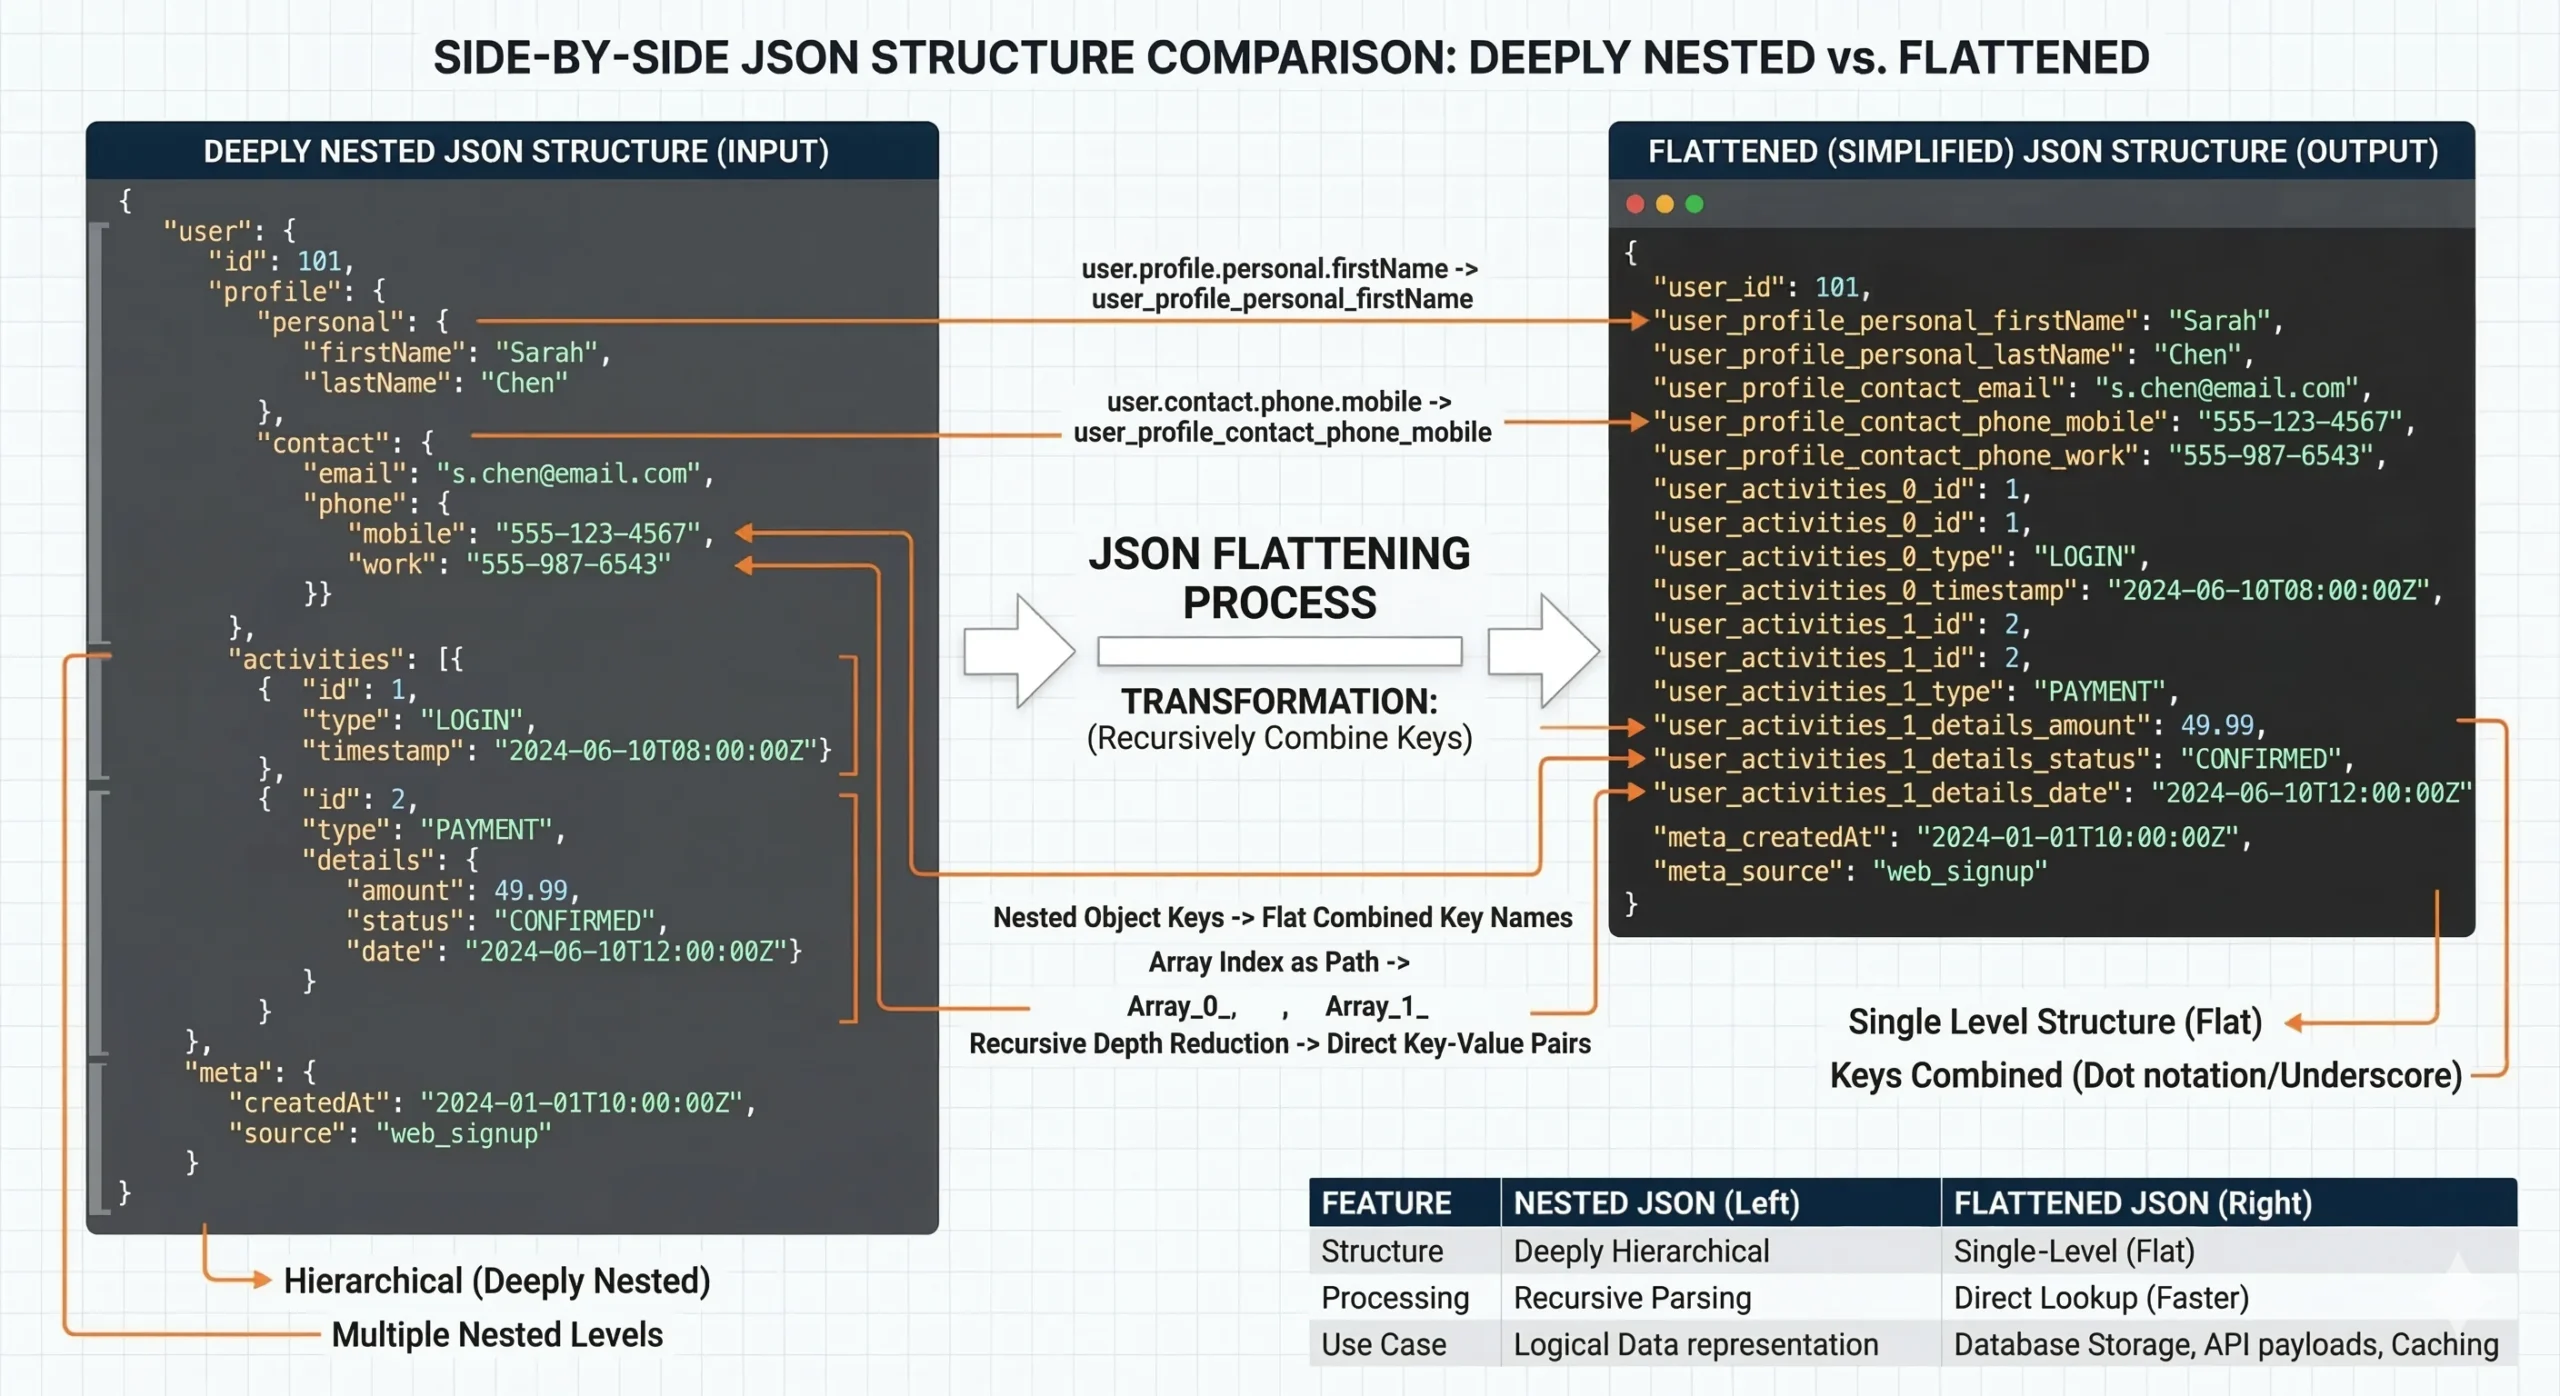
3. 중첩 객체 평탄화(Flattening)
먼저, 다음과 같은 예시를 생각해보자.
{
  "data": {
    "user": {
      "contact": {
        "email": "[email protected]"
      }
    }
  }
}
이 구조에서 email 주소만 따로 떼어내 CRM에 저장하고 싶다면, Set 노드에서 email 필드를 따로 만들고 값에 {{$json.data.user.contact.email}}처럼 지정하면 된다. 간단한 경우라면 이 정도로 충분하지만, 만약 JSON 구조가 동적으로 변한다면 이야기가 달라진다. 이럴 때는 Function 노드에서 try-catch 구문을 쓰거나, lodash 스타일의 get() 함수처럼 안전하게 값을 뽑아주는 도우미 함수를 직접 만들어 써야 한다.
비록 n8n에서 lodash를 기본 제공하지는 않지만, Function 노드 안에 이런 유틸 함수를 직접 추가해두고 계속 재사용하는 것도 좋은 방법이다. 이렇게 하면 다양한 JSON 구조에도 유연하게 대응할 수 있어 실전에 큰 도움이 된다.
4. 배열 처리: map과 filter 적극 활용
API로부터 배열 형태의 응답을 받으면, 각 요소를 별개의 아이템으로 확장해야 할 때가 많다. 이럴 때는 Function 노드에서 다음과 같이 return items.map(item => ({ json: { … } })) 구조로 변환해주면 손쉽게 처리할 수 있다.
특히 n8n의 아이템 기반 처리 방식을 이해하는 것이 중요하다. 하나의 JSON 객체가 아닌, 여러 객체가 모여 있는 배열이라면, n8n은 각각의 객체를 자동으로 분리하여 노드마다 따로 전달한다. 이 특성을 잘 활용하면 반복적인 데이터 처리 로직도 훨씬 직관적으로 작성할 수 있다.
배열을 잘라서 순차 처리하거나 대량 데이터를 안전하게 넘기는 흐름이 필요하다면 [관련 글: n8n Split으로 대량 데이터 안정 처리 완벽 가이드 더 알아보기]를 같이 보면 JSON 배열 처리 감각을 더 빨리 잡을 수 있다.
5. 오류 방지: undefined, null 안전하게 처리하기
실제 업무에서 자주 발생하는 실수 중 하나는 존재하지 않는 필드에 곧장 접근하는 것이다. 예를 들어, {{$json.results[0].id}}를 사용했는데, 만약 results가 빈 배열이라면 워크플로우가 중단될 수 있다. 이런 상황을 막으려면, 표현식 안에서 미리 값 존재 여부를 체크하는 것이 필수다.
예시: {{$json.results && $json.results.length > 0 ? $json.results[0].id : ‘N/A’}}
또는 Function 노드에서 값이 있을 때만 안전하게 넘기는 사전 검증 코드를 추가해도 좋다. “외부에서 들어오는 데이터는 항상 일정하다”는 생각을 버리는 것이 중요하다. 외부 API는 예고 없이 구조를 변경할 수 있기 때문이다.
조건 분기 자체가 헷갈린다면 [관련 글: n8n IF노드로 조건 자동화 완벽 분기 처리 가이드 더 알아보기]를 같이 보면 null 체크와 예외 처리 로직을 더 안정적으로 설계할 수 있다.
📌 핵심 포인트 & 주의사항
API 응답 구조는 언제든 바뀔 수 있음을 늘 염두에 둬야 한다. n8n에서의 JSON 처리는 한 번 설정했다고 끝나는 일이 아니다. 실제 운영 환경에서는 지속적으로 구조를 점검하고, 예외 상황에는 fallback 값이나 알림 기능을 꼭 마련해야 한다.
n8n의 JSON 처리 방식은 처음엔 다소 낯설게 느껴질 수도 있다. 하지만 핵심 원리만 익히면 언제든 반복 업무를 유연하게 자동화할 수 있는 강력한 무기가 된다. 오늘 소개한 실전 패턴을 작게라도 실습해본다면, 앞으로 마주할 더 복잡한 API 통합도 한결 자신 있게 풀어갈 수 있을 것이다.
다음 단계
여기까지 이해했다면 다음으로 세 가지 단계를 익히면 된다. 첫째, 단순한 필드 추출에서 멈추지 말고 배열 확장이나 조건 분기 패턴까지 함께 연습할 것. 둘째, 자주 사용하는 JSON 변환 방식을 Set 노드와 Function 노드 기준으로 구분해두는 것. 셋째, 외부 API 구조가 바뀌었을 때 바로 캐치할 수 있도록 디버깅 포인트를 사전에 설정해두는 것이다. 이러한 습관만 자리 잡으면 복잡한 API 자동화도 훨씬 수월하게 다룰 수 있게 된다.
다음 단계 학습용으로는 [관련 글: n8n Set 노드로 복잡한 데이터 필드 정리하는 완벽 가이드 더 알아보기], [관련 글: n8n IF노드로 조건 자동화 완벽 분기 처리 가이드 더 알아보기], [관련 글: n8n Split으로 대량 데이터 안정 처리 완벽 가이드 더 알아보기] 순서로 이어 보면 JSON 처리 실전 감각을 더 빠르게 키울 수 있다.
참고 자료:
n8n 공식 문서 ·
n8n 표현식(Expression) 공식 문서 ·
n8n 내장 데이터 변수 공식 문서 ·
MDN null 병합 연산자 참고 문서
