

n8n으로 다국어 자동화를 처음 만들 때 많은 사람이 가장 먼저 하는 선택은 언어별 워크플로우를 따로 복사해 두는 방식이다. 처음에는 빨라 보인다. 한국어용 하나, 영어용 하나, 일본어용 하나만 만들어두면 당장 돌아가니까 편해 보이기 때문이다. 그런데 운영이 길어지면 이 방식은 거의 반드시 문제를 만든다. 텍스트 한 줄을 수정할 때마다 세 군데를 손봐야 하고, 알림 채널이나 데이터 필드가 바뀌면 언어별 체인이 조금씩 엇갈리기 시작한다.
실무에서는 번역 품질보다 먼저 무너지는 것이 구조다. 같은 이벤트를 여러 언어로 처리해야 한다는 이유만으로 노드를 복제해 늘어놓으면, 어느 순간부터는 “어떤 분기에서 무엇이 다르게 설정돼 있는지” 추적하는 데 시간이 더 많이 든다. 결국 n8n 다국어 자동화의 핵심은 번역 API 연결 그 자체가 아니라, 언어가 늘어나도 공통 로직은 하나로 유지되는 흐름을 만드는 것에 가깝다.
특히 글로벌 서비스나 해외 사용자 대응이 시작된 뒤에는 알림, 이메일, 템플릿 메시지, 운영 공지 같은 텍스트가 한꺼번에 여러 언어로 흩어진다. 이때 워크플로우를 언어 개수만큼 늘리는 대신, locale과 템플릿 키를 중심으로 구조를 묶어두면 훨씬 안정적으로 관리할 수 있다. 다국어 처리는 “언어별 복사”가 아니라 “같은 처리의 변수화”라고 생각하는 쪽이 맞다.
처음부터 분리형으로 가면 왜 금방 버거워질까
초기 설계 단계에서는 분리형 워크플로우가 단순해 보인다. 언어별로 한 갈래씩 만들어 두면 읽기도 쉽고, 테스트도 직관적이다. 하지만 이 방식은 변경이 생길 때마다 약점이 드러난다. 예를 들어 주문 완료 알림 문구를 수정하거나 Slack 채널명을 바꿔야 할 때, 한국어·영어·일본어 체인을 전부 다시 열어 같은 수정을 반복해야 한다. 작은 차이가 쌓이면 언어마다 결과가 달라지고, 특정 언어만 예전 문구가 남는 식의 사고가 생긴다.
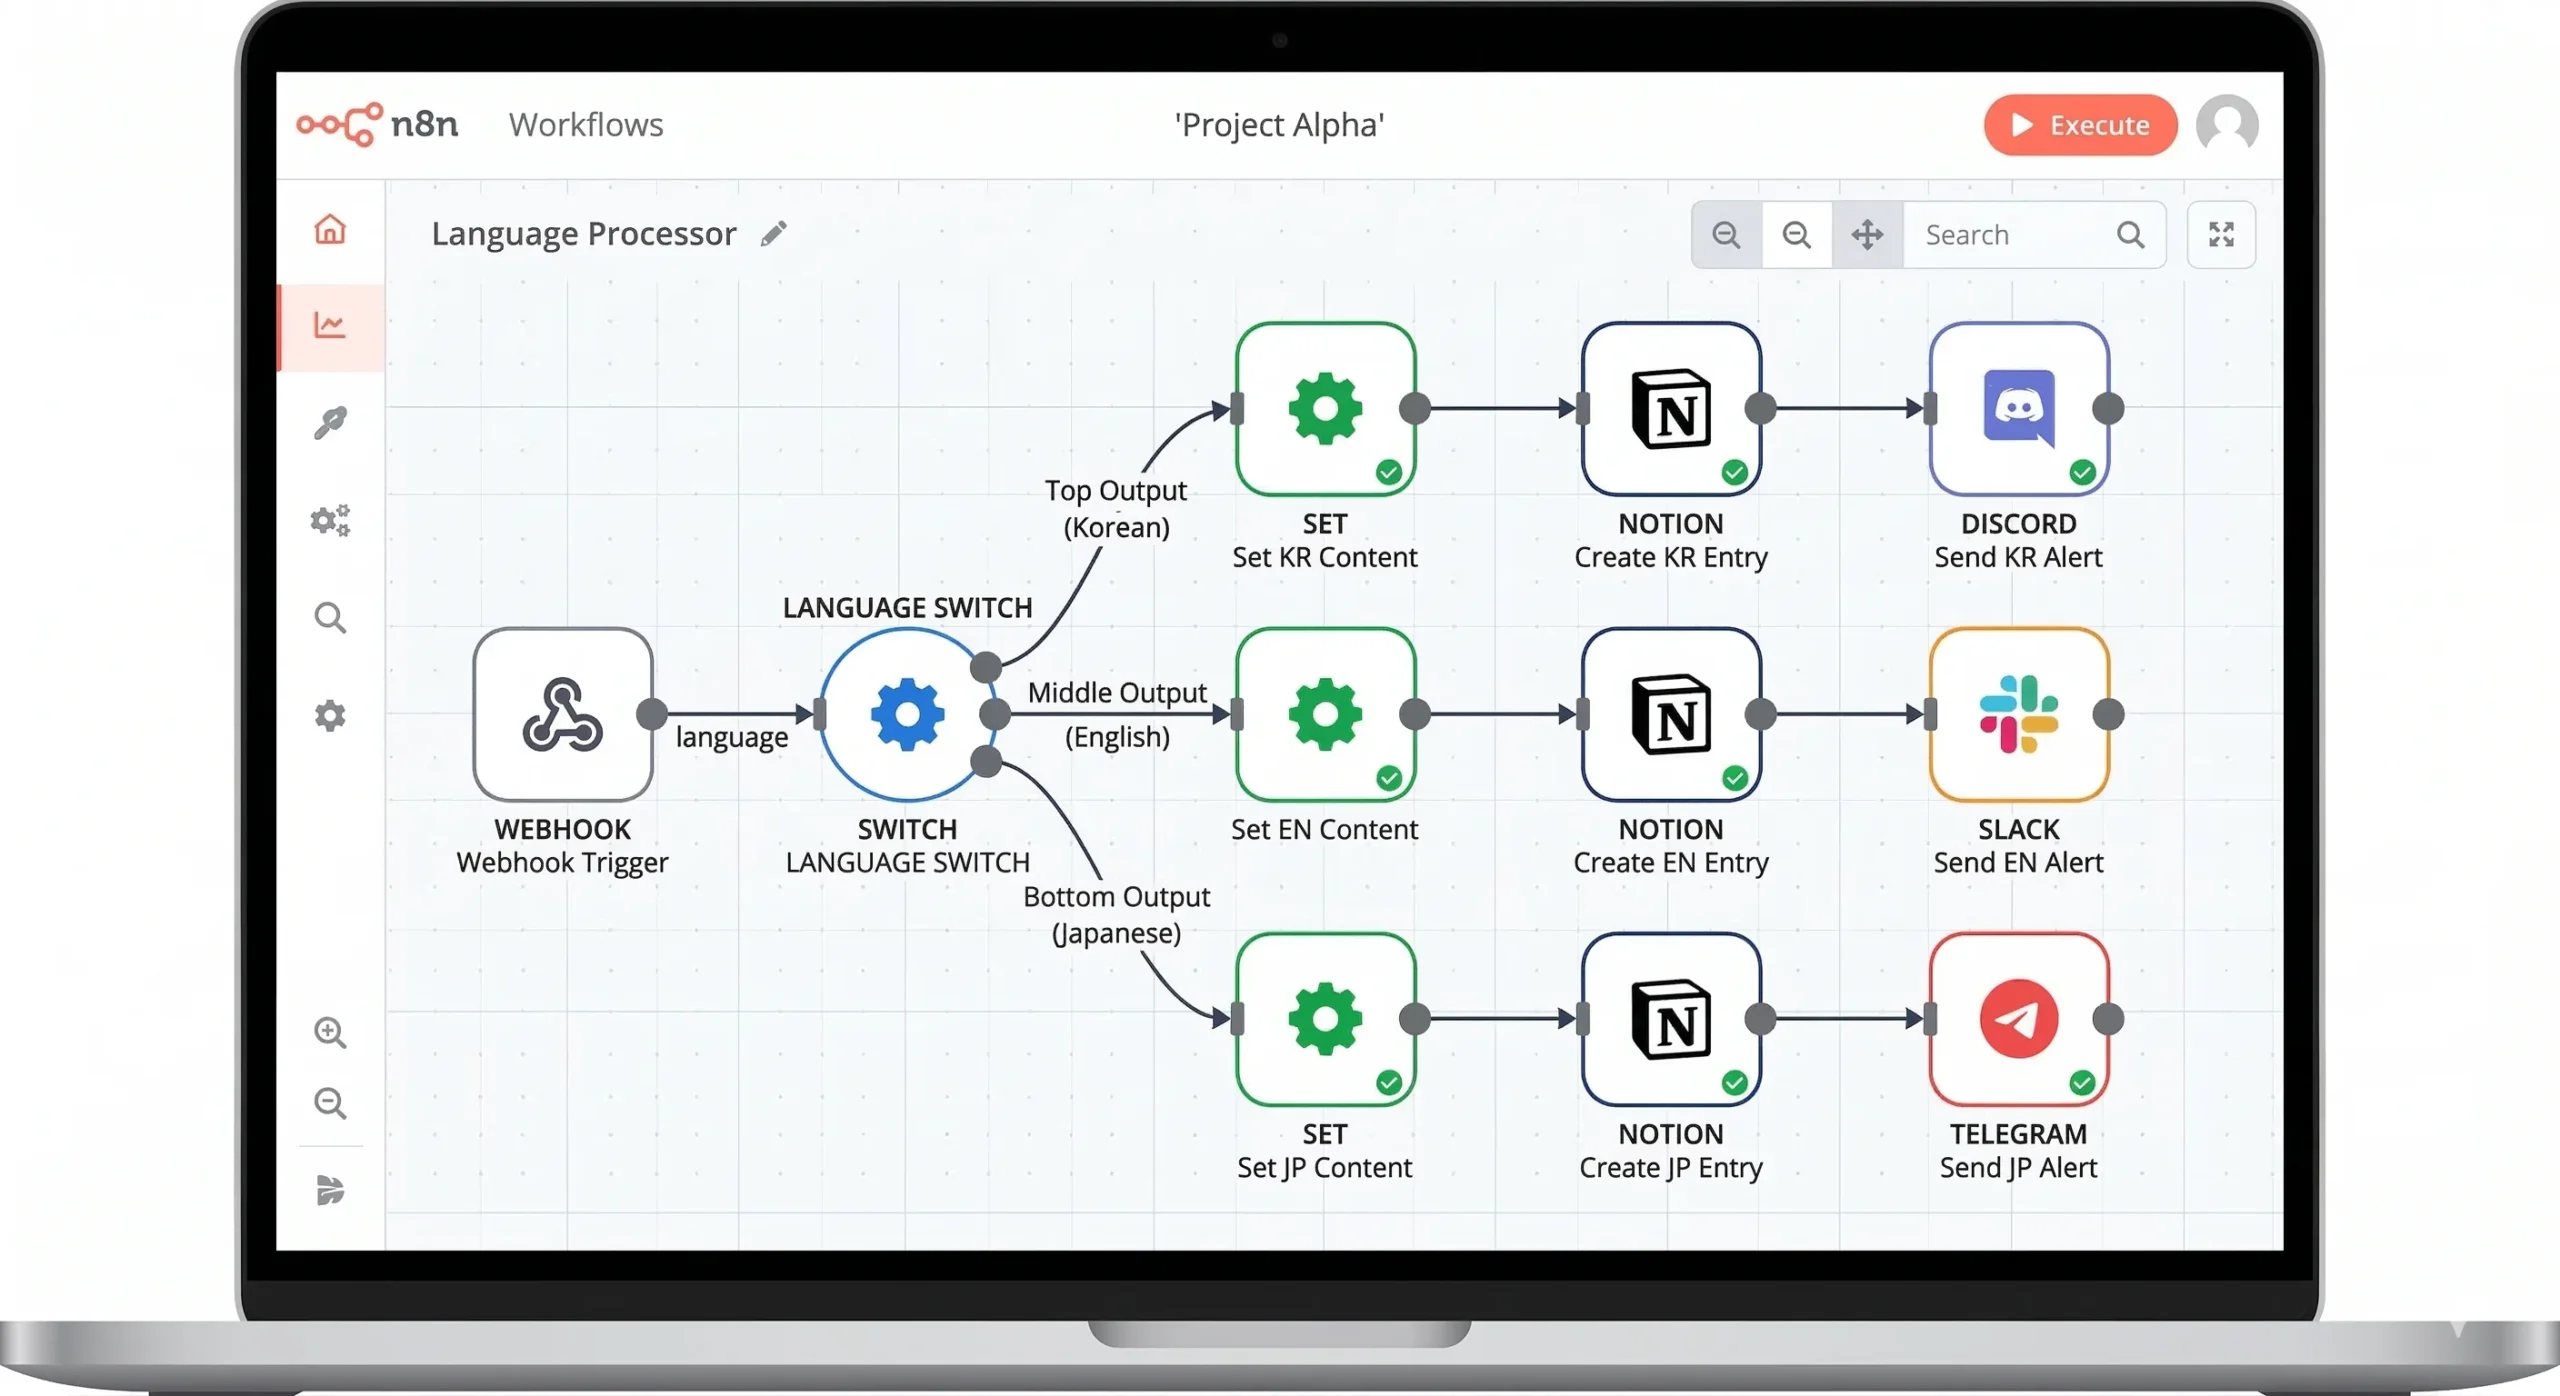
실패 사례도 대부분 비슷하다. Switch 노드 뒤에서 언어별로 전체 체인을 복사해두고, 이후 알림·이메일·시트 기록까지 각각 따로 붙여 놓는 식이다. 처음에는 잘 굴러가지만, 시간이 지나면 유지보수 포인트가 너무 많아져서 “수정은 했는데 일부 언어만 반영 안 된 상태”가 반복된다. 다국어 자동화에서 피해야 할 첫 번째 습관이 바로 이 구조다.
언어를 잡는 방식부터 통일해야 뒤가 편하다
다국어 분기는 결국 “이 입력이 어느 언어인가”를 판단하는 일에서 시작한다. 이 값을 어디서 가져오느냐에 따라 전체 안정성이 꽤 달라진다. 가장 좋은 경우는 사용자 정보에 locale 또는 language 필드가 이미 들어 있는 경우다. 이때는 굳이 외부 감지 API를 거치지 않고, 저장된 값을 그대로 신뢰하는 편이 빠르고 안정적이다.
반대로 사용자 정보가 없다면 웹훅의 Accept-Language 헤더를 읽거나, 필요할 때만 텍스트 감지 API를 폴백으로 쓰는 방식이 현실적이다. 중요한 건 감지 방법이 여러 개일 때도 최종 언어 코드는 하나의 규칙으로 정규화해야 한다는 점이다. 어떤 시스템은 ko, 어떤 곳은 ko-KR, 또 다른 곳은 KOR처럼 제각각 값을 넘겨준다. 이 상태로 분기를 걸면 일부 사용자만 엉뚱한 분기로 빠지는 일이 생각보다 자주 생긴다.
그래서 워크플로우 초입에서 언어 코드를 한 번 정리해두는 편이 좋다. Set 노드나 Code 노드에서 들어온 값을 ISO 639-1 기준의 짧은 코드로 바꿔두면 이후 노드에서는 그 표준값만 보고 처리하면 된다. 이 작은 정규화 단계 하나가 다국어 자동화의 신뢰도를 크게 올린다.
Switch는 분기를 위한 도구이지 복제의 출발점이 아니다
n8n에서 언어 분기를 다룰 때 가장 자연스럽게 떠오르는 노드는 Switch다. 실제로도 적합하다. {{ $json.language }} 같은 값을 기준으로 ko, en, ja 조건을 걸고, 일치하지 않는 값은 Fallback으로 빼면 기본 골격은 쉽게 만들어진다. 문제는 Switch 뒤에 무엇을 두느냐다.
좋지 않은 패턴은 Switch 뒤에 언어별 전체 체인을 그대로 늘어놓는 방식이다. 이렇게 하면 노드 수가 금방 불어나고, 공통 로직을 수정할 때마다 세 군데 이상을 손봐야 한다. 반대로 관리가 쉬운 구조는 “바뀌는 값만 언어별로 정하고, 실제 처리 노드는 최대한 공통으로 두는 방식”이다. 예를 들어 채널명, 제목, 메시지 본문만 언어에 따라 달라진다면 Set 노드에서 이 값만 다르게 만든 뒤, Slack 노드나 이메일 노드는 하나만 두는 쪽이 훨씬 낫다.
웹훅에서 들어온 요청을 기준으로 언어 분기를 시작하는 흐름 자체가 익숙하지 않다면 [관련 글: n8n 웹훅 설정 가이드 오류 없이 연결하는 법 더 알아보기]를 먼저 보고 오면 전체 구조를 이해하기가 훨씬 쉬워진다.
현실적인 설계는 통합형에 가깝다
다국어 자동화 워크플로우는 크게 보면 둘 중 하나다. 언어별로 각각 독립 워크플로우를 운영하는 방식, 또는 단일 워크플로우 안에서 필요한 값만 다르게 바꾸는 통합형 방식이다. 특별한 사정이 없다면 후자가 관리에 유리하다. 공통되는 로직을 한 번만 유지하면 되기 때문이다.
| 패턴 | 어떻게 굴러가는가 | 실무 체감 |
|---|---|---|
| 분리형 | 언어마다 별도 워크플로우 | 초기 이해는 쉽지만 수정 포인트가 빠르게 늘어남 |
| 통합형 | 단일 워크플로우 + 언어별 값만 치환 | 처음 설계는 조금 더 신경 써야 하지만 장기 유지보수에 유리 |
다만 통합형도 아무렇게나 만들면 복잡해진다. 핵심은 공통 단계와 가변 단계를 분리하는 것이다. 예를 들어 주문 데이터를 가져오는 부분, 검증하는 부분, 발송 결과를 기록하는 부분은 공통으로 둘 수 있다. 언어별로 달라지는 것은 제목, 메시지 본문, 일부 채널명, 템플릿 키 정도다. 결국 “변수만 바꿔 흘려보내는 구조”를 만들면 통합형은 생각보다 단순해진다.
시트나 노션 같은 외부 저장소에 다국어 메시지를 모아두고 관리하는 흐름은 [관련 글: n8n 콘텐츠 캘린더 Notion 구글시트로 완전 자동화 더 알아보기]와도 연결된다. 텍스트를 워크플로우 안에 하드코딩하지 않고 밖으로 빼는 감각이 중요하다.
번역 API는 만능이 아니라 보조 수단에 가깝다
언어별 텍스트를 직접 다 준비하기 어렵다면 번역 API를 연결하는 방법도 있다. n8n에서는 HTTP Request 노드로 DeepL이나 Google Cloud Translation API를 호출해 원문을 자동으로 번역할 수 있다. 사용자 리뷰, 문의 내용, 내부 공지 초안처럼 실시간으로 생성되는 텍스트에는 꽤 유용하다.
POST https://api-free.deepl.com/v2/translate
Content-Type: application/x-www-form-urlencoded

auth_key=YOUR_KEY
&text={{ $json.originalText }}
&target_lang={{ $json.targetLang }}
하지만 모든 텍스트를 기계 번역으로만 처리하면 문제가 생긴다. 마케팅 문구, 약관, 고지문처럼 표현이 민감한 콘텐츠는 작은 뉘앙스 차이도 문제가 될 수 있다. 이런 영역은 미리 검수된 템플릿을 따로 두고, 번역 API는 실시간성이 필요한 일반 알림이나 내부 메시지에 제한적으로 쓰는 편이 훨씬 안전하다.
또 하나 자주 놓치는 것이 속도다. 번역 API를 실시간 알림 경로에 그대로 물리면, 외부 API 응답이 지연될 때 전체 발송이 한꺼번에 늦어진다. 그래서 실시간성이 중요한 워크플로우와 배치성 번역 작업은 분리해서 보는 것이 좋다. 자주 쓰는 문구는 미리 번역해 시트나 데이터베이스에 저장해두고, 실시간 경로에서는 이미 준비된 값을 불러오는 식이 안정적이다.
알림 채널은 언어별로 나누되, 노드는 늘리지 않는 편이 낫다
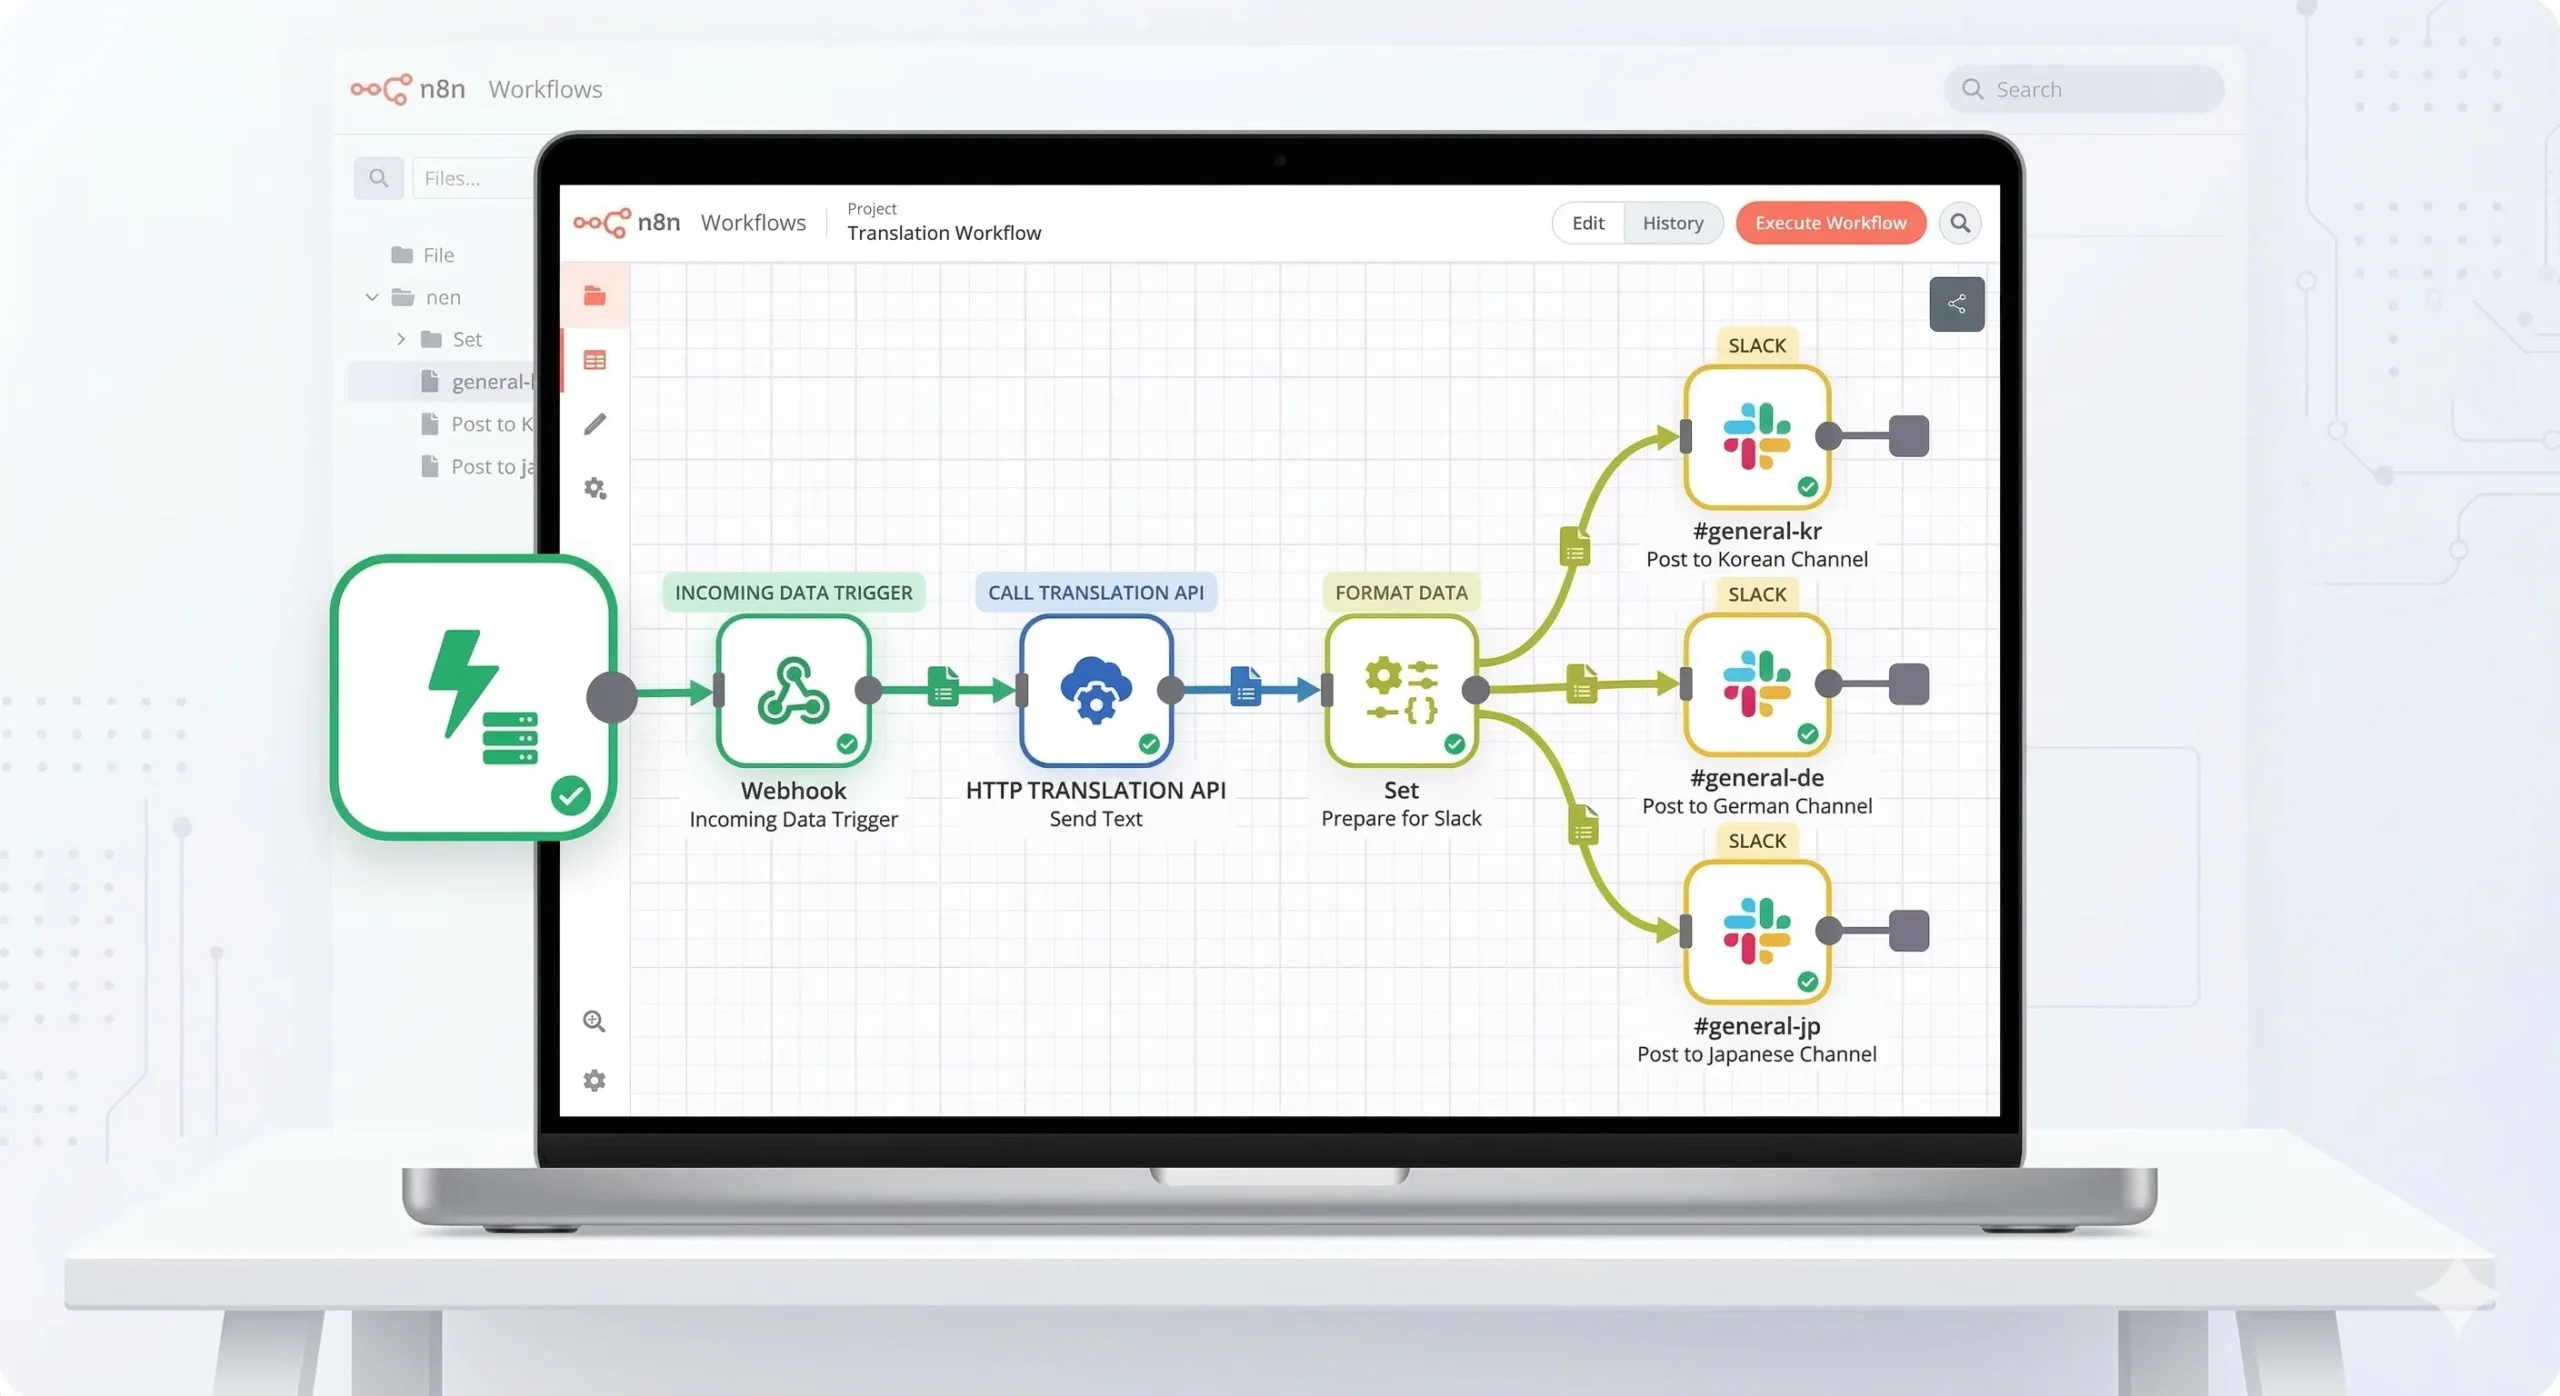
다국어 자동화에서 의외로 손이 많이 가는 부분은 텍스트보다 알림 채널이다. 한국어 팀은 한국어 전용 Slack 채널로, 영어권 담당자는 영어 채널로, 일본 시장 담당자는 또 다른 채널로 보내야 하는 식으로 운영이 달라진다. 이때 흔히 하는 실수는 Slack 노드를 언어별로 여러 개 복제하는 것이다.
더 나은 방법은 언어에 따라 달라지는 값을 먼저 변수로 정리하는 것이다. 예를 들어 Set 노드에서 channelName, messageTitle, messageBody를 언어별로 다르게 만든 뒤, 실제 Slack 노드는 하나만 두고 표현식으로 값을 불러오면 된다. 이메일도 마찬가지다. 제목과 본문만 언어에 맞게 세팅하고, 발송 노드는 하나만 유지하는 편이 구조가 훨씬 단순해진다.
슬랙 알림을 변수화해서 관리하는 감각이 더 필요하다면 [관련 글: n8n 슬랙 자동화로 팀 협업 효율 2배 끌어올리는 방법 더 알아보기]도 같이 참고하면 좋다.
템플릿은 워크플로우 안보다 밖에서 관리하는 쪽이 오래 간다
다국어 자동화가 어느 정도 커지면 결국 텍스트를 어디에 보관할지가 중요해진다. 메시지를 전부 Set 노드 안에 적어 넣으면 처음에는 빨라도, 문구를 수정할 때마다 워크플로우를 열어야 한다. 반대로 구글 시트나 노션, 데이터베이스에 언어 코드별 템플릿을 정리해두면 텍스트 수정과 로직 수정이 분리된다.
| lang_code | welcome_title | welcome_body | order_confirm |
|---|---|---|---|
| ko | 환영합니다! | 가입을 축하드려요. | 주문이 확인되었습니다. |
| en | Welcome! | Thanks for joining. | Your order is confirmed. |
| ja | ようこそ! | ご登録ありがとうございます。 | ご注文が確認されました。 |
이 방식의 장점은 단순하다. 문구를 고칠 때 워크플로우를 건드리지 않아도 되고, 번역 담당자나 운영자도 텍스트만 따로 수정할 수 있다. 다만 외부 저장소에서 값을 불러올 때는 항상 결과가 비어 있을 가능성을 염두에 둬야 한다. 언어 코드가 없거나 키 이름이 틀리면 다음 노드에서 곧바로 에러가 터질 수 있으니, 빈 배열이나 null 값을 체크하는 IF 노드를 하나 두는 습관이 필요하다.
들어오는 언어 코드를 초입에서 정규화하고, 템플릿 조회 결과가 비어 있는 경우에는 기본 언어로 자동 폴백되게 만들어두면 장애를 크게 줄일 수 있다. 작은 설정 같아 보여도 실제 운영에서는 이런 안전장치 하나가 훨씬 중요하다.
실전에서는 번역보다 예외 처리에서 더 많이 막힌다
다국어 자동화 워크플로우를 운영하다 보면 멋진 번역보다 사소한 예외가 더 자주 발목을 잡는다. 대표적인 것이 인코딩 문제다. 한국어와 일본어처럼 멀티바이트 문자가 포함된 데이터를 주고받을 때 헤더 설정이 어긋나면 글자가 깨질 수 있다. HTTP Request 노드를 쓸 때는 Content-Type: application/json; charset=utf-8 같은 기본값을 명시해두는 편이 안전하다.
또 다른 흔한 문제는 Switch 누락이다. 새 언어가 추가됐는데 조건을 깜빡해서 일부 사용자만 Fallback으로 빠지는 경우가 생각보다 많다. 이때는 단순히 기본 메시지로 끝내지 말고, 경고를 별도 채널로 보내도록 해두는 편이 좋다. 그래야 누락을 빠르게 눈치챌 수 있다.
테스트도 한 언어만 보고 넘어가면 안 된다. 실제 배포 전에 최소한 지원하는 모든 언어에 대해 샘플 JSON을 만들어 돌려봐야 한다. 한국어만 정상이고 영어 분기에서는 제목이 비거나, 일본어에서 템플릿 키가 틀린 채 나가는 문제는 대부분 이 단계에서 걸러진다. 자주 쓰는 테스트 세트를 미리 파일로 만들어두면 이후 QA가 훨씬 수월해진다.
운영 과정에서 알림 실패 대응이나 예외 설계를 더 넓게 보고 싶다면 [관련 글: n8n 활용 사례로 만드는 나만의 자동화 포트폴리오 더 알아보기]도 같이 보면 응용 범위를 확장하기 좋다.
결국 중요한 건 언어 수가 아니라 구조의 탄력성이다
다국어 자동화는 처음엔 조금 번거롭다. 하지만 구조를 잘 잡아두면 언어가 하나 늘어날 때마다 새 워크플로우를 복제하는 대신, 템플릿 한 줄을 추가하고 분기 규칙만 갱신하면 된다. 이 차이가 쌓이면 운영 난이도는 완전히 달라진다.
지금 이미 언어별 워크플로우가 여러 개 복붙된 상태라면, 가장 먼저 해야 할 일은 새 기능 추가가 아니라 공통 로직을 하나로 묶는 리팩터링이다. 데이터 수집, 검증, 발송 기록은 공통화하고, 언어별 차이는 템플릿과 변수에만 남기는 쪽으로 방향을 잡아보는 것이 좋다. 다국어 자동화는 언어를 많이 지원하는 기술이 아니라, 언어가 늘어나도 무너지지 않는 구조를 만드는 기술에 더 가깝다.
추가로 이어서 보기 좋은 글은 [관련 글: n8n 구글 스프레드시트 연동으로 데이터 자동화 완벽 실무 가이드 더 알아보기], [관련 글: n8n 콘텐츠 캘린더 Notion 구글시트로 완전 자동화 더 알아보기] 정도면 충분하다. 관련 글을 길게 여러 개 묶기보다, 실제로 다음 단계에 필요한 글만 이어주는 편이 더 자연스럽다.
참고 자료:
n8n 공식 문서 ·
DeepL API 문서 ·
Google Cloud Translation API 문서 ·
Accept-Language 헤더 참고 문서
