

n8n으로 NLP 자동화를 하겠다고 마음먹는 순간, 막상 세팅에 들어가 보면 예상치 못한 곳에서 자꾸 발이 묶인다. “허깅페이스 모델을 API로 연결하면 간단하지 않을까?” 싶다가도, 토큰 인증에서 헤매거나 JSON 파싱이 꼬여서 반나절을 허비한 기억, 한 번쯤은 다들 있을 것이다.
이 글은 n8n NLP 자동화 허깅페이스 실시간 활용법를 처음 적용하는 사람보다도, 이미 한두 번 시도해봤지만 설정 기준이 매번 헷갈렸던 사람에게 더 도움이 되도록 정리했다. 단순 기능 소개보다 실제로 어디서 막히는지, 무엇을 먼저 확인해야 덜 돌아가게 되는지에 초점을 맞췄다.
특히 이 주제는 비슷한 설명이 반복되는 경우가 많아 보이지만, 실제 작업에서는 환경과 목적에 따라 판단 기준이 달라진다. 그래서 아래 내용도 정답 하나를 밀어붙이기보다, 선택이 갈리는 지점을 중심으로 읽는 편이 훨씬 도움이 된다.
워크플로우 자동화 도구인 n8n은 노코드 환경에서 외부 서비스를 손쉽게 연결할 수 있다는 점이 가장 큰 장점이다. 하지만 NLP 모델을 연동하려고 하면 이야기가 달라진다. 공식 문서를 아무리 찾아봐도 허깅페이스 전용 노드는 존재하지 않고, 관련 가이드도 좀처럼 눈에 띄지 않는다. ‘어디서부터 시작해야 하지?’ 하는 막막함에 부딪히기 쉽다. 그래서 이번 글에서는 HTTP Request 노드 하나만을 활용해 허깅페이스 Inference API 호출 과정을 직접 구축하고, 실시간 NLP 결과까지 받아내는 실제 과정을 꼼꼼하게 정리해보고자 한다. 실제로 부딪혔던 시행착오와 함께 말이다.
이 글에서 다루는 핵심
허깅페이스 모델을 n8n에 연동하고 싶지만 전용 노드나 뚜렷한 가이드가 없어 막막했던 이들에게 실질적인 해법을 제시한다. 토큰 인증부터 HTTP Request 노드 설정, JSON 응답 파싱, 그리고 콜드 스타트나 rate limit 같은 실제 운영 이슈까지 한 번에 점검할 수 있도록 도울 예정이다.
💡 3줄 요약
- n8n의 HTTP Request 노드와 허깅페이스 추론 API 호출 방식을 조합하면 코드 한 줄 없이도 NLP 모델을 실시간으로 호출할 수 있다.
- 감성 분석, 텍스트 분류, 번역, 요약 등 다양한 NLP 작업을 워크플로우 안에서 자동으로 처리할 수 있다.
- API 응답 지연, 모델 로딩 대기, 인증 토큰 관리, 응답 구조 차이처럼 실전에서 자주 막히는 포인트를 미리 알고 들어가야 운영이 편하다.
n8n NLP 자동화가 필요한 순간
예를 들어, 하루에도 수백 건씩 고객 리뷰가 쌓이는 상황을 생각해보자. 감성 분석을 직접 일일이 한다는 건 비현실적이다. 스프레드시트에 복사해서 붙여넣고 읽어내는 작업은, 시간도, 체력도 아깝다.
n8n은 이런 반복적인 데이터 처리 흐름을 시각적으로 설계할 수 있도록 돕는 오픈소스 자동화 플랫폼이다. 트리거(웹훅, 예약 실행, 메일 수신 등)가 신호를 보내면, 사전에 정해둔 노드 순서대로 업무가 흐른다. 여기에 허깅페이스 추론 호출을 넣으면, 텍스트가 들어오는 족족 자동으로 NLP 모델이 돌아가는 파이프라인을 만들 수 있다.
무엇보다 Python 스크립트를 서버에 올리지 않아도 되고, 별도의 서버리스 함수 구성까지 바로 들어갈 필요가 없다는 점이 큰 장점이다. 물론 대규모 데이터에는 한계가 있지만, 소규모나 중간 규모 트래픽이라면 n8n NLP 자동화만으로도 충분히 프로토타입과 실무 보조 자동화를 만들 수 있다.
1. n8n NLP 자동화가 특히 유용한 작업
가장 먼저 떠올리기 쉬운 건 리뷰 감성 분석이다. 하지만 실제로는 고객 문의 자동 분류, 긴 문서 요약, 다국어 문의 1차 번역, 회의 메모에서 인물·회사명 추출 같은 작업도 잘 맞는다.
핵심은 사람이 매번 읽고 판단하는 단계를 줄이는 데 있다. 완벽하게 사람을 대체하기보다, 사람이 확인해야 할 텍스트 양을 줄이고 우선순위를 먼저 나눠주는 역할로 쓰면 효율이 확실히 올라간다.
2. 실제 경험: 처음 붙일 때 가장 오래 막히는 지점
처음 이 흐름을 만들 때 가장 오래 걸렸던 건 모델 선택보다도 응답 구조 확인이었다. 토큰 인증까지는 비교적 빨리 끝났는데, 막상 HTTP Request 노드 실행 결과를 열어보니 모델마다 반환 구조가 조금씩 달라서 Set 노드에서 값을 바로 못 꺼내는 경우가 많았다.
특히 감성 분석처럼 배열 안에 배열이 들어오는 응답은 겉으로 보기엔 단순해 보여도, 실제 Expression에서 $json[0][0].label처럼 접근해야 해서 초반에 자주 꼬인다. 그래서 이 조합은 “API 호출 자체”보다 “응답 구조를 먼저 확인하고 다음 노드 설계를 맞추는 것”이 더 중요하다는 걸 빨리 이해하는 편이 좋다.
허깅페이스 추론 호출 기본 구조
허깅페이스는 현재 모델별 서버리스 추론을 위한 문서를 Inference Providers 중심으로 안내하고 있다. 실제 호출 방식은 모델과 제공 방식에 따라 조금씩 달라질 수 있지만, n8n에서는 결국 HTTP Request 노드로 인증 헤더와 JSON 바디를 구성하는 흐름이 핵심이다.
3. API 토큰 발급과 인증 방식
허깅페이스 계정에 로그인한 뒤 Settings → Access Tokens에서 토큰을 만들면 된다. 단순 추론 호출만 할 목적이라면 과도한 권한보다는 필요한 최소 권한으로 시작하는 편이 안전하다.
발급받은 토큰은 n8n에서 Credential로 등록해두면 편하다. HTTP Request 노드를 쓸 때 Header Auth를 고르고, Header Name에 Authorization, Value에는 Bearer hf_xxxxx 식으로 입력하면 된다. 이렇게 한 번 지정해두면, 워크플로우 전반에서 계속 같은 토큰을 재사용할 수 있다.
여기서 꼭 알아둘 점이 있다. 무료 사용 범위와 호출 제한은 계정 상태, 모델, 제공 방식에 따라 달라질 수 있다. 그래서 “분당 몇 회까지 무조건 가능하다”처럼 고정값으로 외우기보다, 실제 운영 전에는 허깅페이스 계정 대시보드와 최신 문서를 같이 확인하는 편이 안전하다.
4. 엔드포인트 URL과 요청 본문 구성
가장 널리 알려진 방식 중 하나는 https://api-inference.huggingface.co/models/{모델명} 형태로 모델 추론을 호출하는 것이다. 다만 최신 허깅페이스 문서에서는 Inference Providers 구조도 함께 안내하고 있으니, 장기 운영이나 유료 전환을 고려한다면 해당 문서도 같이 보는 것이 좋다.
기본적인 Body에는 분석할 텍스트를 JSON 형태로 넣으면 된다. 예를 들어 {"inputs":"분석할 텍스트"} 같은 형태다. 복잡한 파라미터를 나중에 붙일 수는 있지만, 처음 연결할 때는 입력 구조를 최대한 단순하게 시작하는 편이 디버깅이 쉽다.
| 항목 | 설정값 | 비고 |
|---|---|---|
| HTTP Method | POST | 대부분 추론 호출은 POST로 시작 |
| URL | https://api-inference.huggingface.co/models/{모델명} | 모델 Hub와 최신 문서에서 재확인 권장 |
| Header | Authorization: Bearer hf_xxxxx | Credential로 관리 권장 |
| Body | {“inputs”: “텍스트”} | JSON 형식 |
n8n NLP 자동화 워크플로우 단계별 구축
워크플로우를 직접 만들어 보자. 여기서는 감성 분석을 예시로 들지만, 모델만 바꾸면 번역, 요약, 개체명 인식 등 여러 작업에도 똑같이 적용된다.
5. 트리거 노드 설정 — Webhook 활용
가장 범용적으로 쓰는 방식이 바로 Webhook 트리거다. 외부 시스템(챗봇, 폼, Slack, 사내 앱 등)에서 텍스트를 POST 방식으로 보내주면 n8n 워크플로우가 바로 실행된다.
Webhook 노드를 캔버스에 올린 뒤, HTTP Method를 POST로 선택한다. Path는 자유롭게 정하면 되고, 이후 외부 호출 URL이 되니 기억해두는 게 좋다. 테스트 모드에서 Listen for Test Event를 누르면 대기 상태로 전환된다. 이 상태에서 Postman이나 cURL로 샘플 데이터를 보내면 입력 구조를 확인할 수 있다.
6. HTTP Request 노드로 허깅페이스 호출 설정
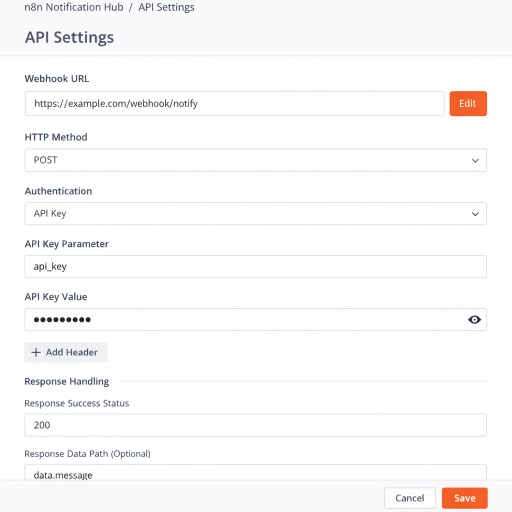
Webhook 다음엔 HTTP Request 노드를 연결한다. 앞서 정리한 URL, Header, Body 내용을 그대로 입력해주면 된다. Body 입력 시에는 Expression 모드를 활용하는 것이 핵심이다.
Body JSON의 inputs 값에 {{ $json.body.text }} 이런 식으로 설정하면, Webhook에서 넘어온 텍스트가 그대로 허깅페이스 API로 전달된다. 이 한 줄 덕분에 수동 복사&붙여넣기 대신 자동 처리로 전환할 수 있다.
응답 형식은 JSON으로 지정해두자. n8n 공식 HTTP Request 노드는 다양한 REST API 호출에 맞게 응답 형식, 재시도, 배치 옵션까지 지원하므로, 단순 테스트를 넘어 운영으로 갈수록 이 옵션들을 같이 보는 편이 좋다.
7. 결과 가공 — Set 노드와 IF 분기
API 응답을 그대로 사용하면 데이터가 지저분해질 수 있다. Set 노드를 활용해서 label과 score처럼 필요한 정보만 추려내면 훨씬 보기 좋다.
감성 분석 결과가 POSITIVE나 NEGATIVE로 나온다면, IF 노드를 달아 score가 0.8 이상일 때만 Slack 같은 곳에 알림을 보내도록 분기 처리도 가능하다. 이런 조건 분기가 있으면 n8n NLP 자동화의 활용폭도 한층 넓어진다.
실전 NLP 활용 시나리오
감성 분석 외에도 허깅페이스에는 다양한 모델이 올라와 있다. 단순히 모델만 바꿔도 전혀 다른 NLP 작업을 쉽게 할 수 있다는 점이 이 조합의 진짜 매력이다.
8. 텍스트 요약 자동화
facebook/bart-large-cnn 같은 요약 모델을 연결하면, 긴 기사나 보고서를 3~4문장으로 자동 요약할 수 있다. 뉴스레터나 내부 보고서 축약 작업에 특히 유용하다.
다만 입력할 수 있는 텍스트 길이에 제한이 있다. 문서가 너무 길면 미리 여러 덩어리로 나눠서 보내야 하고, 요약 전에 불필요한 머리말·바닥글·HTML 조각을 제거해두면 결과 품질도 더 좋아진다.
9. 다국어 번역 파이프라인
Helsinki-NLP 계열 모델을 사용하면 한국어와 영어, 일본어 간 번역도 할 수 있다. 고객 문의가 여러 언어로 들어오는 환경이라면, 번역부터 감성 분석, 분류, 담당자 배정까지 하나의 워크플로우에 묶을 수 있다. n8n NLP 자동화의 활용 폭이 가장 넓어지는 구간이다.
10. 개체명 인식(NER)과 키워드 추출
dslim/bert-base-NER 모델을 쓰면 텍스트에서 사람 이름, 장소, 조직명 등을 자동으로 뽑아낼 수 있다. 예를 들어 영업팀이 모은 미팅 메모에서 회사명이나 담당자 이름을 추출해 CRM에 바로 입력하는 흐름이 대표적이다.
결과가 BIO 태그 형태로 나오기 때문에, 후처리를 위한 Function 노드를 하나 추가해 태그를 합치고 정리하면 실무에서 훨씬 보기 좋게 쓸 수 있다.
| NLP 태스크 | 추천 모델 | 주요 용도 |
|---|---|---|
| 감성 분석 | distilbert-base-uncased-finetuned-sst-2-english | 리뷰/피드백 분류 |
| 텍스트 요약 | facebook/bart-large-cnn | 뉴스·보고서 축약 |
| 번역 | Helsinki-NLP/opus-mt-ko-en | 다국어 고객 응대 |
| 개체명 인식 | dslim/bert-base-NER | CRM 데이터 자동 입력 |
트러블슈팅과 주의사항
워크플로우를 배포하고 나면 생각보다 여러 가지 에러를 자주 접하게 된다. 미리 알고 있으면 디버깅에 드는 시간을 훨씬 줄일 수 있다.
11. 실패/주의 사례 — 가장 많이 터지는 조합
실제로 가장 자주 터지는 조합은 세 가지다. 첫째, 토큰은 맞는데 Header 형식이 잘못돼 401 또는 403이 나는 경우. 둘째, 모델은 살아 있지만 무료 추론이 바로 응답하지 않아 503 또는 모델 로딩 대기 메시지를 받는 경우. 셋째, API 호출은 성공했는데 Set 노드 Expression이 응답 구조와 안 맞아 빈 값만 남는 경우다.
이 중에서 특히 마지막 케이스가 시간을 제일 많이 잡아먹는다. “호출은 성공했으니 다 된 것 같다”라고 생각하고 다음 노드를 붙였는데, 정작 출력값이 비어 있으면 나중에 Slack 알림이나 DB 저장 단계에서 이상하게 꼬인다. 그래서 허깅페이스 연동은 HTTP Request 성공 여부만 보지 말고, 반드시 응답 JSON 구조를 먼저 눈으로 확인한 뒤 다음 노드 Expression을 맞추는 순서로 가는 편이 안전하다.
12. 모델 로딩 지연(콜드 스타트) 문제
무료 또는 서버리스 추론에서 특히 많이 마주치는 이슈다. 일정 시간 이상 호출이 없던 모델을 사용할 때는 모델 로딩 대기가 발생할 수 있다. 이 경우 바로 실패로 단정하지 말고, 일시적 응답 지연인지 먼저 확인하는 편이 낫다.
해결 방법은 두 가지가 있다. 첫째, n8n의 Retry on Fail 옵션을 켜 두면 일시적인 실패를 자동으로 다시 시도할 수 있다. 둘째, 일정한 간격으로 모델에 더미 요청을 보내 워밍업 상태를 유지하는 별도 스케줄 워크플로우를 둘 수도 있다. 다만 후자는 불필요한 호출 비용을 만들 수 있으니, 실제 트래픽과 비용 구조를 보고 판단하는 편이 좋다.
13. 응답 데이터 파싱 오류
모델마다 응답 JSON 구조가 제각각 다르다. 감성 분석은 이중 배열로, 번역은 단일 객체나 텍스트 필드로 오는 식이다. n8n으로 NLP 자동화 워크플로우를 만들 때 가장 많이 실수하는 부분이 바로 이 파싱 단계다.
HTTP Request 노드 실행 후 출력 패널에서 응답 JSON 구조를 먼저 확인하고, 그에 맞춰 Set 노드에서 Expression을 작성하는 습관이 중요하다. 예를 들어 $json[0][0].label처럼 인덱스를 지정해 접근해야 할 때가 많다.
📌 핵심 포인트 & 주의사항
대량 데이터를 다룰 때는 한 건씩 무작정 보내기보다 n8n의 배치 옵션이나 Split In Batches 노드를 활용해 호출 간격을 조정하는 편이 안전하다. n8n 공식 문서도 HTTP Request 노드에서 배치 전송과 Retry on Fail 옵션을 제공하므로, rate limit이 걱정되는 경우 이 기능부터 먼저 활용하는 편이 좋다.
그리고 한 가지 더—한국어 NLP 모델은 영어 모델보다 선택 폭과 품질 편차가 더 크다. 한국어 감성 분석이나 분류가 목적이라면, 범용 영어 모델을 억지로 쓰기보다 모델 카드와 예제 입력을 먼저 확인하고 실제 샘플 텍스트로 짧게 검증해 보는 과정이 꼭 필요하다.
공식 문서 확인 포인트
- n8n HTTP Request 노드 공식 문서
- n8n HTTP Request 공통 이슈 문서
- Hugging Face Inference Providers 공식 문서
- Hugging Face 첫 API 호출 가이드
다음 단계
가장 좋은 시작은 감성 분석 하나만 붙여보는 것이다. 먼저 Webhook으로 텍스트를 받고, HTTP Request 노드로 허깅페이스 모델을 호출한 다음, Set 노드에서 label과 score만 뽑아보자. 여기까지 되면 이미 n8n NLP 자동화의 핵심 구조는 잡힌 셈이다.
그 다음에는 같은 패턴으로 요약, 번역, 개체명 인식 중 하나를 추가해보면 된다. 처음부터 거대한 파이프라인을 만들기보다, 응답 구조 확인 → 파싱 → 분기 처리까지 짧은 흐름을 하나 완성해두면 이후 확장이 훨씬 쉬워진다.
n8n 기반의 NLP 자동화는 복잡한 인프라 없이도 텍스트 데이터를 실시간 처리하는 실용적 방법이다. 반드시 완성형을 목표로 하기보다는, 먼저 빠르게 프로토타입을 만들어 직접 데이터를 다뤄보고 점진적으로 고도화하는 과정이 훨씬 현실적이다. Webhook을 하나 열어 두고 작게 워크플로우를 돌려보면, 직접 화면에서 결과를 보는 순간 다음 자동화 아이디어가 자연스럽게 떠오를 것이다.
참고 자료:
n8n 공식 문서 ·
n8n HTTP Request 노드 문서 ·
Hugging Face Inference Providers 문서 ·
Hugging Face 첫 API 호출 가이드
