

n8n 웹훅이 예고 없이 실패하는 순간, 예상보다 크게 당황하게 된다. 외부 서비스에서는 단순히 “전송 실패” 메시지만 표시되고, n8n에서는 404인지 403인지, 아니면 아예 응답이 지연되어 끊긴 것인지 한눈에 파악하기 어려운 경우가 많다. 특히 Slack이나 GitHub, Stripe, 각종 폼 서비스처럼 웹훅 기반 자동화에 의존하는 상황이라면, 한 번의 실패가 단순한 알림 누락에 그치지 않고 전체 프로세스가 멈추는 심각한 문제로 이어질 수 있다.
실무에서는 에러 메시지의 길이나 표현 방식보다, 오류 코드가 가리키는 범위를 속히 좁히는 것이 무엇보다 중요하다. 404는 대개 경로나 활성화 상태 문제일 가능성이 크고, 403은 접근 권한이 차단된 경우가 많다. 타임아웃이라면 요청이 접수되었지만, 지정된 시간 안에 응답이 돌아오지 않았을 때 주로 발생한다. 이렇게 세 가지 상황만 명확히 구분해도, 막연히 n8n 화면만 들여다보는 것보다는 훨씬 빠르게 원인을 좁힐 수 있다.
이 글에서는 단순히 에러 코드의 의미를 나열하는 것에 그치지 않고, 실제로 웹훅이 정상 동작하지 않을 때 어디서부터 확인하면 시간을 효율적으로 줄일 수 있는지에 초점을 맞춰 정리하고자 한다. n8n을 클라우드 환경에서 사용하는 경우와 직접 서버를 운영하는 셀프호스팅 환경, 두 가지를 모두 고려했다. 테스트 URL과 프로덕션 URL 혼동, 리버스 프록시 설정 누락, 실행 시간 초과 등 흔히 발생하는 실수 지점을 중심으로, 어떻게 문제 해결의 실마리를 찾을 수 있는지 짚어보겠다.
웹훅 오류는 코드별로 보는 게 가장 빠르다
웹훅 장애가 발생했을 때 흔히 저지르는 실수 중 하나는 문제의 원인을 한꺼번에 너무 넓게 펼쳐놓고 보는 것이다. 이럴 때 워크플로우 설정을 뒤져보고, 외부 서비스 설정을 확인하고, 서버 상태를 살피고, SSL 인증서, 방화벽 설정까지 한꺼번에 점검하다 보면, 오히려 원인을 찾는 데 더 많은 시간이 소요되곤 한다. 하지만 실제로는 에러 코드를 정확히 구분하기만 해도 점검 범위를 크게 좁힐 수 있다.
예를 들어, 404 Not Found 오류가 발생한다면 대개 n8n에서 해당 웹훅 경로를 찾지 못할 때이다. 이는 워크플로우가 비활성화되어 있거나, 테스트할 때 URL을 잘못 적었거나, 혹은 경로가 변경된 경우에 자주 나타난다.
반면 403 Forbidden 오류는 경로 자체는 올바르지만 접근이 거부된 상황에서 발생한다. 이 경우에는 n8n 내부 문제보다는 Nginx, Caddy, Cloudflare와 같은 프록시 설정, 서버 방화벽이나 인증 헤더, SSL 관련 설정을 먼저 점검하는 것이 더 효과적이다.
마지막으로 타임아웃 오류는 요청이 정상적으로 들어왔지만 응답이 너무 늦어져서 중간에 연결이 끊긴 경우다. 이런 상황에서는 n8n 워크플로우 실행 시간과 리버스 프록시의 시간 제한을 함께 확인해야 한다. 특히 셀프호스팅 환경에서는 n8n 로그상으로는 문제가 없어 보이는데, 실제로는 앞단 프록시가 먼저 연결을 종료해 외부 서비스에서는 실패로 처리되는 경우도 적지 않다.
결국, 다양한 장애 상황에서 에러 코드의 의미를 정확히 파악하고 단계적으로 범위를 좁혀가며 점검하면, 불필요하게 시간을 허비하지 않고 더 빠르고 정확하게 원인을 찾아낼 수 있다.
웹훅 자체 흐름이 아직 익숙하지 않다면 [관련 글: n8n 웹훅 설정 가이드 오류 없이 연결하는 법 더 알아보기]를 먼저 같이 보는 편이 좋다. 기본 구조를 알고 있어야 오류 구간도 빨리 보인다.
404가 출력되면 제일 먼저 URL부터 의심해야 한다
404 에러는 생각보다 단순한 실수에서 자주 발생한다. 특히 많이 보이는 원인 중 하나는 테스트 URL과 프로덕션 URL을 헷갈리는 경우다. 예를 들어 n8n의 웹훅 노드에는 두 종류의 URL이 있는데, ‘테스트 URL’은 에디터에서 ‘Listen for Test Event’를 켜 놓았을 때만 잠깐 활성화된다. 반면 ‘프로덕션 URL’은 워크플로우가 Active 상태일 때만 정상적으로 작동한다. 만약 외부 서비스에 테스트 URL을 입력해 놓고 워크플로우만 활성화했다면, 설정을 모두 마쳤다고 생각할 수 있지만 실제로 호출은 계속 404 에러로 끝난다.
이런 문제는 비단 초보자만 겪는 것이 아니다. 워크플로우를 수정하거나 테스트하다가 무심코 테스트 URL을 복사해 Stripe, Slack, GitHub 등 외부 서비스에 붙여넣는 경우도 종종 있다. 그래서 404 에러가 발생한다면 복잡한 설정을 의심하기 전에, 우선 등록한 URL이 진짜로 프로덕션 URL인지 다시 한 번 확인하는 것이 가장 기본이자 중요한 점검 포인트다.
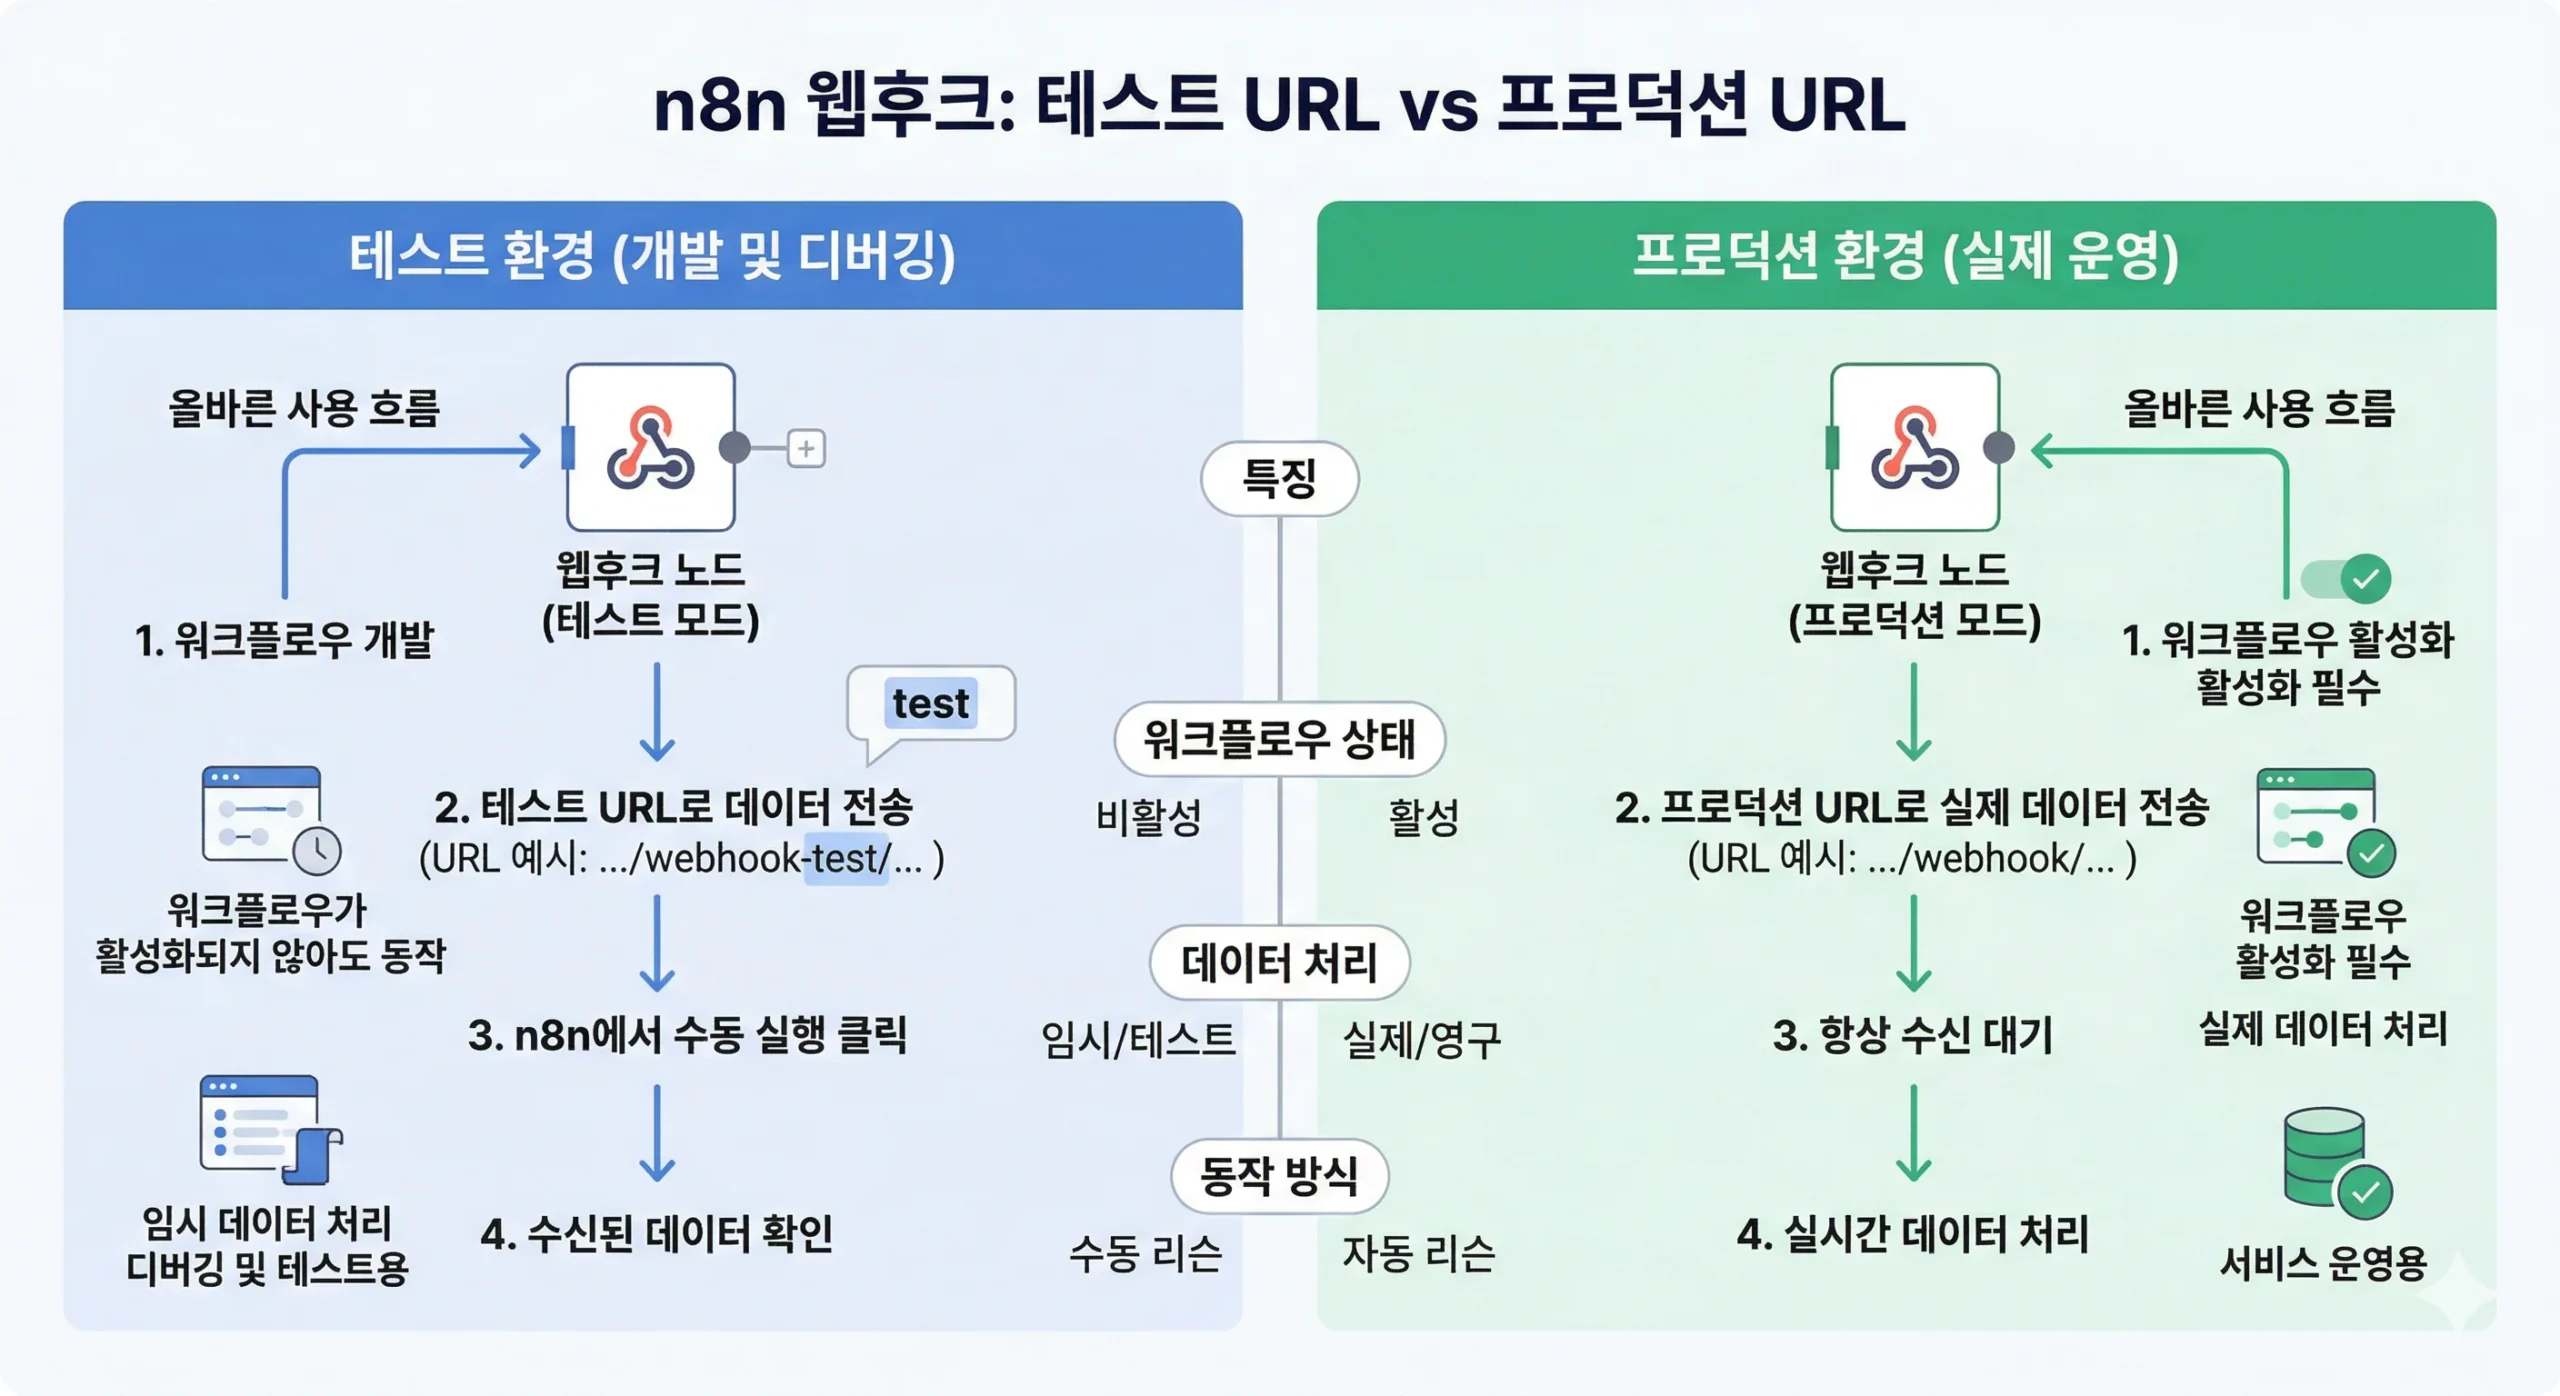
404가 발생하는 두 번째 흔한 이유는 워크플로우가 비활성화되어 있는 경우다. 저장만 해두고 활성화 토글을 다시 켜지 않았거나, 에러가 난 뒤 워크플로우가 꺼진 상태를 놓치는 일이 생각보다 자주 일어난다. 프로덕션 환경에서 URL을 쓴다면 워크플로우가 활성화된 상태여야만 제대로 동작하기 때문에, 반드시 URL 확인 후 워크플로우가 켜져 있는지도 함께 점검해야 한다.
세 번째 원인은 경로 오타다. 경로를 직접 입력했을 때, 하이픈이나 슬래시, 혹은 철자 하나만 달라도 404 오류로 이어진다. 특히 셀프호스팅 환경에서는 환경변수에 등록한 WEBHOOK_URL이 실제 도메인과 다르면, 애초에 생성되는 URL 자체가 잘못될 수 있다. Docker Compose나 .env 파일로 배포 중이라면, 이 값 역시 꼼꼼히 확인해두는 것이 좋다.
403은 n8n보다 앞단에서 막히는 경우가 더 많다
403 오류가 발생하면 많은 이들이 우선 “웹훅 노드 권한부터 잘못된 게 아닐까?”라고 생각하곤 한다. 실제로 인증 설정 실수도 흔한 원인 중 하나이지만, 셀프호스팅 환경에서는 리버스 프록시나 방화벽 같은 네트워크 구조가 요청을 가로막는 경우가 훨씬 더 자주 등장한다.
Nginx를 사용하는 경우라면, 가장 먼저 /webhook/ 또는 /webhook-test/ 경로가 정상적으로 프록시되고 있는지부터 확인해야 한다. location 블록 설정이 어긋나거나, 일부 경로만 빠져 있으면 외부 서비스는 403이나 그와 유사한 접근 거부 응답을 받는다. Caddy나 Traefik을 쓸 때도 상황은 다르지 않다. 앞단 설정이 요청을 가로채면 n8n 컨테이너에는 아예 요청이 도달하지 않으니, 내부 실행 기록조차 거의 남지 않는다는 점도 염두에 둘 필요가 있다.
방화벽의 존재도 종종 간과된다. 서버 포트만 열려 있다고 안심하겠지만, 특정 국가의 IP나 대역, 혹은 특정 헤더를 기준으로 차단 규칙이 남아 있으면 외부 서비스에서 들어오는 웹훅 요청만 막히는 상황도 생길 수 있다. 클라우드 환경, 예를 들어 AWS, GCP, Oracle Cloud처럼 보안 그룹이 별도로 운영되는 서버라면, OS 방화벽과 클라우드 보안 그룹 설정 모두를 꼼꼼히 확인해야 한다.
다시 인증 설정을 살펴보자. n8n 웹훅에 Basic Auth나 Header Auth 같은 인증을 추가했음에도 외부 서비스 쪽의 헤더 설정을 갱신하지 않았다면, 또다시 403 문제가 발생한다. 특히 운영 도중 보안을 강화하려고 인증만 새로 도입하고 기존 웹훅 발송 서비스는 그대로 놔두는 경우, 바로 이 지점에서 오류가 가장 많이 터진다.
SSL 인증서 문제도 완전히 무시해서는 안 된다. 인증서가 만료됐거나 self-signed 상태라면, 외부 서비스가 해당 요청 자체를 신뢰하지 않을 수 있다. 비록 반드시 403만 발생하는 건 아니지만, 사용자 입장에서는 대부분 “접근 거부”로 받아들이게 된다. 셀프호스팅 환경에서 HTTPS를 직접 관리한다면, 인증서 갱신 자동화가 제대로 작동하고 있는지도 꼭 확인하는 것이 안전하다.
서버 앞단 구성이 익숙하지 않다면 [관련 글: n8n VPS 설치부터 도메인 HTTPS 설정까지 완벽 가이드 더 알아보기]나 [관련 글: n8n 보안 완벽 가이드 자격 증명과 웹훅을 안전하게 관리하는 법 더 알아보기]를 같이 참고하면 점검 범위를 정리하기 쉽다.
타임아웃은 실행 시간과 응답 전략을 같이 봐야 한다
타임아웃이 까다로운 이유는, 요청이 겉으로는 완전히 실패한 것처럼 보여도 실제로는 어딘가에서 여전히 처리 중일 수 있기 때문이다. 외부 서비스에서는 ‘응답 없음’으로 남더라도, n8n 내부에서는 작업이 계속 돌거나, 혹은 특정 지점에서 멈춘 채 남아있을 수 있다. 그래서 단순히 “처리가 느려서 실패했다”라고만 판단하면 안 되며, 어디서 먼저 연결이 끊겼는지, 세밀하게 들여다볼 필요가 있다.
우선 확인해야 할 것은 n8n의 Executions 탭이다. 이곳에서 각 노드가 소요한 시간을 살펴보면 어느 단계에서 지연이 발생했는지 대략적으로 파악할 수 있다. 외부 API 호출이 길어지거나, 반복 작업이 많거나, 이미지 생성이나 파일 업로드, 혹은 무거운 Code 노드가 있으면 전체 응답 시간이 순식간에 늘어난다.
이어서 웹훅(Webhook) 노드의 응답 방식도 중요하다. 만약 웹훅 노드가 “When Last Node Finishes”로 설정되어 있다면, 워크플로가 완전히 끝날 때까지 응답이 보류된다. 반대로 “Immediately”로 설정하면 외부 요청에는 곧장 200 OK를 반환하고, 이후 처리는 n8n이 백그라운드에서 계속 진행한다. 작업 결과를 실시간으로 반환할 필요가 없다면, 이 방식이 실제로 타임아웃을 우회할 가장 현실적인 대안이 될 수 있다.
셀프호스팅 환경에서는 리버스 프록시의 시간 제한도 반드시 고려해야 한다. 예를 들어 Nginx의 proxy_read_timeout 값이 60초인데, 실제 워크플로 처리가 70초가 걸린다면 n8n은 아무 일 없이 계속 동작하지만, 앞단 프록시가 먼저 연결을 끊어버린다. 이럴 경우 외부에서는 실패나 타임아웃으로 보이지만, 정작 n8n 내부에서는 정상 완료로 기록될 수도 있다. 결국 문제의 원인이 n8n 내부가 아니라 프록시나 네트워크 구간에 있을 수도 있는 것이다.
n8n 자체의 실행 제한 또한 환경 설정에 따라 다르게 적용될 수 있다. 셀프호스팅에서는 EXECUTIONS_TIMEOUT, EXECUTIONS_TIMEOUT_MAX 같은 환경 변수로 최대 실행 시간을 설정한다. 서버 과부하 방지를 위해 제한을 너무 짧게 두었다가 실제 운영 워크플로가 중간에 잘리는 경우도 있기 때문에, 장시간 실행되는 자동화라면 이 부분까지 꼼꼼히 챙겨야 한다.
이렇게 여러 환경 변수와 설정, 그리고 실제 흐름까지 하나하나 따져봐야 타임아웃의 진짜 원인을 찾아낼 수 있다. 표면적으로 드러나는 현상에만 집중해서는 문제 해결이 쉽지 않다.
대량 처리나 반복 구조가 많은 자동화라면 [관련 글: n8n 성능 최적화 실전 병렬 처리 전략 총정리 더 알아보기]와 같이 보면 도움이 된다. 타임아웃은 설정 문제이기도 하지만, 결국 워크플로우 구조 문제일 때도 많기 때문이다.
실제 점검은 한 번에 다 하지 말고 순서대로 해야 한다
웹훅 연결이 잘 되지 않는다고 해서 처음부터 서버 설정, SSL, DNS, n8n 노드, 외부 서비스 콘솔까지 모두 한 번에 열어볼 필요는 없다. 차근차근 순서를 따라가는 편이 훨씬 신속하게 문제를 찾을 수 있다.
먼저 404인지 403인지 타임아웃인지를 구분한다.
404라면 URL, 프로덕션 URL 여부, 활성화 상태, Path 오타부터 본다.
403이라면 프록시, 방화벽, 인증 헤더, SSL 순으로 본다.
타임아웃이라면 Executions에서 노드 시간을 보고, 그다음 Respond 설정과 프록시 timeout 값을 확인한다.
이렇게 순서대로 접근해야 하는 이유는, 그래야만 문제의 원인 범위를 빠르게 좁힐 수 있기 때문이다. 가령 404 상황에서 방화벽부터 건드리는 건 시간만 허비하는 셈이고, 타임아웃 문제가 발생했는데 URL 경로만 집요하게 바꾸는 것 역시 도움이 되지 않는다. 결국 웹훅 장애를 해결하는 일은 ‘숨겨진 한 가지 원인을 찾아내는 것’보다는, 확실히 아니라는 후보들을 조기에 지워나가는 과정에 가깝다.
| 증상 | 가장 먼저 볼 것 | 주요 원인 |
|---|---|---|
| 404 Not Found | 프로덕션 URL, Active 상태 | 테스트 URL 혼동, 워크플로우 비활성, 경로 오타 |
| 403 Forbidden | 프록시·방화벽·인증 | 차단 규칙, 인증 헤더 누락, SSL 문제 |
| Timeout | Executions 시간, Respond 설정 | 느린 외부 API, 긴 실행, 프록시 시간 제한 |
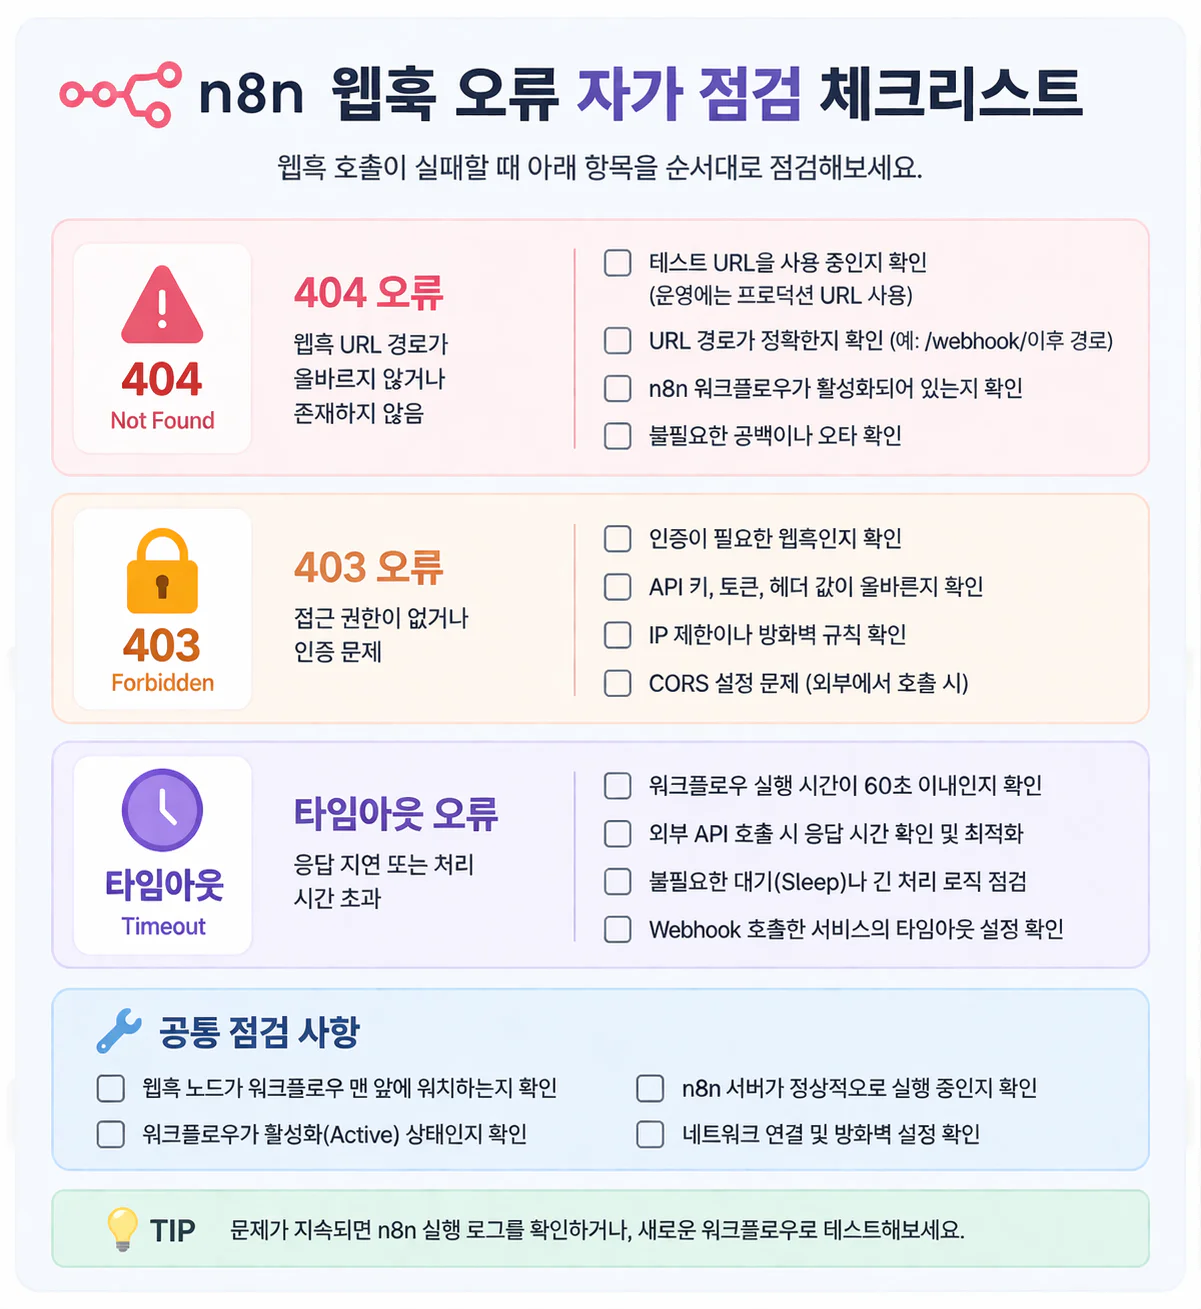
실제로 제일 먼저 체크할 항목
워크플로우가 제대로 활성화되어 있는지 먼저 점검하고, 외부 서비스에 등록된 주소가 실제 프로덕션 URL과 일치하는지도 다시 한 번 살핀다. 주소가 잘못됐다면 404 오류는 금방 원인을 찾을 수 있다.
만약 403 오류가 발생한다면, 단순히 n8n 화면에서 확인하는 것보다 서버 전방 설정부터 짚어보는 것이 효율적이다. 프록시 경로가 올바른지, 방화벽이나 인증 헤더 설정에 문제가 없는지, 혹은 SSL 인증서가 만료되진 않았는지까지 꼼꼼히 체크하는 편이 훨씬 빠른 길이다.
타임아웃 문제라면, Executions 메뉴에서 오래 걸리는 노드를 먼저 찾아보는 것이 좋다. 필요하다면 Respond Immediately 방식으로 워크플로우 구조를 바꿔볼 수도 있다. 셀프호스팅 환경이라면, 서버 프록시의 timeout 값 또한 함께 확인하는 것이 문제 해결에 도움이 된다.
자주 묻는 질문
Q. 테스트할 때는 되는데 운영에서만 404가 뜹니다. 왜 그런가요?
대부분의 경우 테스트 URL은 외부 서비스에만 등록되어 있다. 이 URL은 ‘Listen for Test Event’ 기능을 활성화한 동안에만 작동하며, 실제 운영 환경에서는 반드시 프로덕션 URL을 사용해야 한다. 시험용과 운영용 주소를 혼동하면 예기치 못한 오류가 발생할 수 있으니, 각 환경에 맞는 URL을 정확하게 입력하는 것이 중요하다.
Q. 403이 뜨면 n8n 인증 문제라고 보면 되나요?
섣불리 단정짓기엔 어렵다. 셀프호스팅 환경에서는 인증 문제보다는 오히려 리버스 프록시, 방화벽, Cloudflare, SSL 등 앞단에서 발생하는 요소들이 문제의 원인일 때가 훨씬 많다. 실제로 이런 경우를 먼저 확인하는 편이 훨씬 효율적이다.
Q. 웹훅 타임아웃은 시간을 늘리면 무조건 해결되나요?
항상 그런 것은 아니다. 실행 시간이 오래 걸리는 구조라면, 그 구조 자체를 줄이거나 먼저 응답을 보내고 나머지 처리는 백그라운드에서 진행하는 방법이 더 적합할 때도 있다. 시간을 단순히 늘리는 방식은 임시방편에 불과한 경우가 많다.
Q. n8n 클라우드와 셀프호스팅은 점검 포인트가 다른가요?
웹훅 노드의 기본 구조는 비슷하지만, 셀프호스팅 환경에서는 WEBHOOK_URL 설정부터 프록시, 방화벽, SSL 관리까지 모두 직접 책임져야 한다. 이런 이유로 인프라에서 발생할 수 있는 다양한 변수가 더 많이 개입된다. 반면, 클라우드 환경에서는 관리 범위가 제한적이어서 상대적으로 단순하게 구성할 수 있다.
n8n 웹훅 오류를 처음 마주하면 당황스럽기 마련이지만, 404와 403, 그리고 타임아웃 에러만 제대로 구분해도 문제의 원인을 금세 좁힐 수 있다. 예를 들어 404 에러가 뜬다면 웹훅 URL이나 활성화 여부를 먼저 점검하면 되고, 403은 접근 권한이 막혀 있는지를 확인해야 한다. 타임아웃 문제라면 실행 시간과 응답 방식에 초점을 맞추면 된다. 이렇게 원인을 크게 세 갈래로 나누기만 해도 디버깅 속도가 훨씬 빨라진다.
특히 셀프호스팅 환경에서는 n8n만 들여다보고 끝내지 말고, 프록시나 방화벽, SSL 설정, 환경변수까지 꼼꼼하게 함께 점검하는 습관이 필요하다. 반대로 클라우드 환경에서는 괜히 인프라 쪽 문제부터 의심하기보다는, 먼저 URL이나 응답 방식, 실행 시간을 차근차근 정리해보는 것이 더 합리적이다. 결국 웹훅 문제를 해결하는 과정은 단순히 감에 의존하는 일이 아니라, 드러난 증상에 맞춰 한 단계씩 범위를 좁혀가며 원인을 추적하는 일과도 같다.
참고 자료: n8n 공식 문서 – Webhook Node
