

n8n을 활용해 자동화 워크플로우를 설계하다 보면, 기본으로 제공되는 노드만으로는 해결이 어려운 순간이 분명히 온다. 처음에는 Set, Edit Fields, If, Merge 같은 노드만으로도 충분해 보인다. 하지만 실제 운영에 들어가면 외부 API 응답 구조가 예상보다 훨씬 복잡하거나, 중첩된 JSON을 원하는 형태로 다시 만들거나, 여러 필드를 한 번에 계산해서 다음 단계로 넘겨야 하는 경우가 자주 생긴다. 이쯤 되면 단순 노드 조합만으로는 오히려 구조가 더 복잡해지고, 유지보수도 어려워진다.
저도 처음에는 Code 노드를 “정말 어쩔 수 없을 때만 쓰는 마지막 수단”처럼 봤다. 그런데 몇 번 직접 써보니 오히려 반대였다. 노드가 여럿 엉키기 시작할 때, 아주 짧은 자바스크립트 몇 줄이 워크플로우 전체를 훨씬 읽기 쉽게 만들어주는 경우가 많았다. 문제는 코드가 어렵다는 데 있지 않았다. 진짜 어려운 건 n8n이 데이터를 어떤 구조로 넘겨주는지, 현재 아이템과 전체 아이템을 어떻게 구분해야 하는지, 그리고 무엇을 Code 노드 안에서 해결하고 무엇은 그냥 기본 노드로 두는 게 더 나은지를 구분하는 일이었다.
많은 글이 아직도 Code 노드를 예전 Function 노드 감각으로 설명하거나, 외부 라이브러리를 아무 환경에서나 자유롭게 가져다 쓸 수 있는 것처럼 설명한다. 하지만 현재 공식 문서 기준으로는 몇 가지를 분명히 구분해서 봐야 한다. self-hosted에서는 Code 노드에서 외부 npm 모듈과 Node.js 내장 모듈을 허용 환경 변수로 열어줄 수 있지만, n8n Cloud에서는 외부 npm 모듈을 자유롭게 가져올 수 없고 예외적으로 crypto와 moment만 사용 가능하다. 또한 파이썬 지원도 자바스크립트와 완전히 동일한 수준으로 보면 안 된다. 즉 지금의 Code 노드는 “자유로운 코드 실행 공간”이라기보다, n8n이 허용하는 범위 안에서 데이터를 정교하게 가공하는 노드라고 보는 편이 더 정확하다.
실제로는 연결 성공보다, 같은 실수를 반복하지 않게 구조를 잡는 단계가 더 오래 남는다. Code 노드는 복잡한 흐름을 억지로 길게 잇는 대신, 데이터 구조를 한 번에 정리해 다음 노드가 읽기 쉽게 만드는 데 가장 큰 가치가 있다.
그래서 이 글에서는 원문의 실무 감각은 살리되, 현재 공식 문서 기준과 실제 운영 기준에 맞게 Code 노드를 다시 정리해보려 한다. $input.all()과 $json을 언제 어떻게 써야 하는지, 자주 쓰는 배열 메서드가 왜 중요한지, 외부 라이브러리는 어떤 환경에서 어떻게 허용되는지, Luxon을 왜 날짜 처리 표준처럼 보는지, 그리고 실제로 어떤 테스트를 해보면 데이터 누락과 타입 오류를 빨리 잡을 수 있는지를 실무 기준으로 풀어보겠다.
직접 여러 번 써보니, Code 노드는 “노드를 줄이기 위한 도구”라기보다, n8n이 넘겨주는 데이터를 사람이 의도한 구조로 다시 정리하는 도구에 더 가까웠다.
n8n Code 노드가 필요한 이유: 기본 노드로 해결되지 않는 순간
원문처럼 워크플로우가 복잡해질수록 노드 수가 빠르게 늘어난다. 단순한 필드 정리라면 Edit Fields (Set)나 If, Merge, Split 계열만으로도 충분할 수 있다. 하지만 외부 API가 중첩된 객체를 반환하고, 그중 일부만 꺼내 다시 묶어야 하거나, 여러 배열을 한 번에 계산해서 새로운 출력 구조를 만들어야 하는 경우엔 기본 노드만으로는 오히려 구조가 더 복잡해지는 순간이 온다.
바로 그 지점에서 Code 노드의 가치가 생긴다. 공식 문서도 Code 노드를 데이터 변환과 JavaScript/Python 실행을 위한 노드로 설명하고 있고, 현재 아이템만 처리할지, 전체 아이템을 한 번에 처리할지까지 모드를 구분해 제공한다. 즉 Code 노드는 “노드를 코드로 대신하는 곳”이라기보다, 기본 노드로는 표현이 길어지는 데이터 가공을 더 직접적으로 처리하는 곳이라고 보면 편하다.
실무적으로 보면 Code 노드는 만능은 아니다. 단순한 필드 하나 추가나 조건 하나 분기 정도라면 굳이 코드를 쓰지 않는 편이 더 읽기 쉽다. 하지만 노드 5개, 6개를 이어야 겨우 되는 구조가 자바스크립트 몇 줄로 더 명확해진다면, 그때는 Code 노드가 오히려 유지보수성을 높여준다. 저도 결국 많이 쓰게 된 이유가 “더 멋진 자동화” 때문이 아니라 “더 덜 헷갈리는 자동화” 때문이었다.
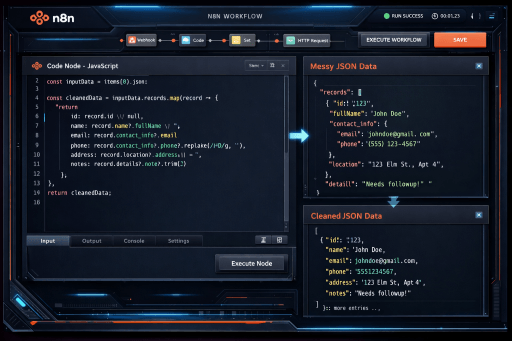
1. n8n 데이터 구조와 객체 접근법
원문에서 가장 중요한 포인트는 이 부분이었다. n8n은 데이터를 기본적으로 아이템 배열 구조로 다루고, 각 아이템 안의 실제 데이터는 json 속성 아래에 들어 있다. 현재 공식 문서도 $json을 현재 아이템의 JSON 데이터에 대한 축약 표현으로 설명하고, $input.all()은 현재 노드로 들어온 전체 아이템 배열을 반환한다고 안내한다. 이 차이를 모르면 Code 노드에서 가장 흔하게 데이터를 하나만 처리하거나, 반대로 전체를 의도치 않게 중복 처리하는 실수가 나온다.
즉 이렇게 이해하면 편하다. $json은 “지금 이 아이템 하나”, $input.all()은 “현재 노드로 들어온 전체 묶음”이다. 예를 들어 각 아이템마다 가공이 필요하면 $json이 직관적이고, 전체 배열을 한 번에 순회하며 요약값을 만들거나 합산할 때는 $input.all()이 자연스럽다.
처음엔 이 차이가 사소해 보이지만, 실제로는 여기서 가장 많이 틀린다. 저도 예전에는 현재 아이템 하나만 다루려던 코드에서 $input.all()을 써버려 전체 데이터를 다시 순회하는 바람에 결과가 중복된 적이 있다. 결국 Code 노드의 절반은 자바스크립트보다 입력 구조를 이해하는 데 달려 있다고 봐도 크게 틀리지 않다.
2. 효율적인 데이터 가공을 위한 필수 메서드
원문처럼 Code 노드에서 자주 쓰는 핵심 메서드는 map, filter, reduce다. 여러 아이템을 새 구조로 변환하거나, 특정 조건을 만족하는 것만 남기거나, 합계·개수·평균처럼 누적 계산을 해야 할 때 거의 빠지지 않는다. 이런 패턴은 기본 노드 조합으로도 흉내 낼 수 있지만, 복잡해질수록 코드 몇 줄이 훨씬 명확해지는 경우가 많다.
예를 들어 여러 쇼핑몰 가격 응답을 모아 특정 금액 이하 상품만 걸러내고, 총액과 건수를 동시에 구해야 한다면 filter와 reduce 조합이 아주 자연스럽다. 이걸 노드만으로 풀려면 If, Set, Merge, Aggregate 비슷한 구조를 길게 이어야 할 수 있다. 물론 기본 노드가 나쁘다는 뜻은 아니다. 단지 로직이 “배열을 어떻게 다룰 것인가”로 바뀌는 순간부터는 Code 쪽이 더 읽기 쉬운 경우가 많다.
| 구분 | 기본 노드 조합 | Code 노드 활용 |
|---|---|---|
| 유연성 | 기본 제공 기능 내에서 조합 | 배열 처리, 조건 계산, 구조 재정렬을 더 자유롭게 표현 가능 |
| 가독성 | 노드 수가 많아지면 흐름이 길어질 수 있음 | 로직이 한곳에 모여 있어 복잡한 변환은 오히려 더 읽기 쉬울 수 있음 |
| 처리 방식 | 노드 간 이동이 많아질수록 구조가 길어짐 | 메모리 안에서 직접 가공하므로 복잡한 배열 로직에 유리할 수 있음 |
실전 트러블슈팅과 성능 최적화 전략
Code 노드는 단순히 “동작하느냐”보다, 실제 환경에서 얼마나 안정적으로 동작하느냐가 더 중요하다. 데이터가 수십 건일 때는 괜찮아도, 수천 건을 한 번에 읽기 시작하면 메모리 사용량, 실행 시간, 외부 API 호출 수, 예외 처리 구조가 모두 체감된다. 그래서 Code 노드는 짧게 쓰는 게 중요한 게 아니라, 무슨 작업을 어디까지 맡길지를 분명히 하는 게 더 중요하다.
원문처럼 무한 루프와 비동기 처리에 대한 감각은 분명 중요하다. 다만 현재 공식 문서 기준으로 Code 노드를 설명할 때는 “자바스크립트가 다 된다”보다, 현재 n8n이 허용하는 실행 환경 안에서 무엇을 할 수 있는지 보는 쪽이 더 정확하다. 특히 외부 모듈, 내장 모듈, Python 지원, Cloud와 self-hosted 차이는 분명히 구분해서 봐야 한다.
3. 외부 라이브러리와 복잡한 날짜 연산
원문에서 Luxon 같은 외부 라이브러리를 추가해 활용하라고 쓴 부분은 방향은 맞지만, 현재 공식 문서 기준으로는 표현을 조금 다르게 가져가는 편이 더 정확하다. n8n은 날짜와 시간을 다룰 때 Luxon의 DateTime 사용을 권장하고 있으며, Code 노드와 표현식에서도 Luxon을 사용할 수 있다고 문서가 안내한다. 즉 날짜 처리를 위해 꼭 외부 npm 패키지를 따로 허용해야 한다는 식으로 이해하면 오히려 현재 구조와 어긋날 수 있다. n8n은 워크플로우 간 날짜/시간을 문자열로 변환해 다루므로, 일반 JS Date()보다 Luxon 접근이 워크플로우 타임존과 더 잘 맞는다.
예를 들어 “주말을 제외하고 3일 뒤에 실행” 같은 조건은 단순 Date 연산보다 Luxon 기반으로 풀어야 타임존과 문자열 포맷 문제를 덜 겪는다. 실제로는 이 차이가 꽤 크게 난다. 특히 워크플로우 타임존이 적용되는 환경에선 일반 자바스크립트 날짜 처리보다 Luxon 쪽이 훨씬 덜 헷갈린다.
또한 외부 npm 모듈 사용은 환경별로 명확히 나눠서 봐야 한다. self-hosted에서는 n8n 환경에 모듈이 실제로 설치되어 있어야 하고, NODE_FUNCTION_ALLOW_EXTERNAL 및 필요하면 NODE_FUNCTION_ALLOW_BUILTIN으로 허용해야 한다. 반면 Cloud에서는 외부 npm 모듈을 자유롭게 가져올 수 없고, 예외적으로 crypto와 moment만 지원된다. 즉 원문처럼 “호스트에 설치하고 환경 변수만 주면 어디서나 된다”라고 이해하면 현재 기준으로는 틀릴 수 있다.
4. 비동기 처리와 에러 핸들링
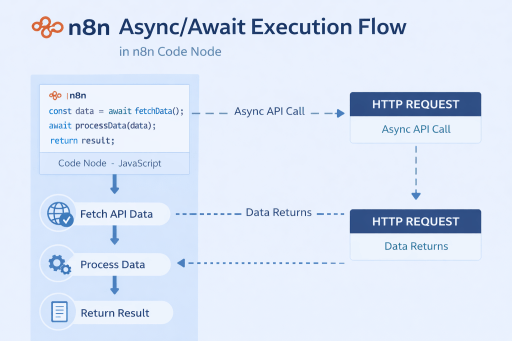
원문처럼 비동기 처리에서 async/await 감각은 중요하다. 다만 Code 노드 안에서 외부 HTTP 호출을 무작정 늘리는 건 늘 좋은 선택은 아니다. 이미 HTTP Request 노드가 있는 경우, 외부 호출은 전용 노드에 맡기고 Code 노드는 데이터 조합과 계산에 집중시키는 편이 더 읽기 쉬운 경우가 많다. 그럼에도 Code 안에서 비동기 처리가 필요하다면, 워크플로우가 결과를 제대로 인식하도록 await 흐름을 분명히 해야 한다.
에러 핸들링도 마찬가지다. try…catch는 분명 유용하지만, 모든 예외를 무조건 삼켜버리면 오히려 디버깅이 어려워질 수 있다. 실무에서는 실패해도 되는 구간과 실패하면 전체를 멈춰야 하는 구간을 구분하는 편이 더 중요하다. 예를 들어 일부 값 정제 실패는 기본값으로 대체할 수 있지만, 핵심 식별자 생성 실패는 그대로 에러를 올리는 편이 낫다.
현재 문서 기준으로 꼭 알아야 할 지원 범위
5. JavaScript와 Python은 지원 수준이 다르다
원문 FAQ에서는 파이썬과 자바스크립트를 꽤 대등하게 설명하고 있지만, 현재 공식 문서 기준으로는 그대로 보면 조금 위험하다. Code 노드의 native Python은 자바스크립트와 동일한 수준으로 모든 built-in methods와 variables를 지원하지 않는다. 공식 문서는 Python이 all-items 모드에서는 _items, per-item 모드에서는 _item 정도만 지원하고, 다른 n8n built-in methods와 variables는 지원하지 않는다고 분명히 안내한다. self-hosted Python 확장도 task runners와 allowlist가 전제다. 즉 현재 기준으로는 Code 노드 활용 면에서 자바스크립트가 훨씬 중심적인 선택지라고 보는 편이 정확하다.
그래서 실무적으로는 이렇게 보는 편이 낫다. n8n 기본 데이터 구조와 내장 변수 활용이 중요하다면 자바스크립트가 더 자연스럽고, Python은 환경과 지원 범위를 먼저 충분히 확인한 뒤에 검토하는 편이 좋다. 원문처럼 “분석이면 파이썬, 제어면 자바스크립트” 정도로만 단순화하면 현재 문서 기준 지원 범위를 놓치기 쉽다.
6. 외부 패키지는 설치와 허용이 둘 다 있어야 한다
원문 FAQ에서 환경 변수 예시는 방향은 맞지만, 중요한 조건 하나가 더 있다. 허용만 한다고 모듈이 생기진 않는다. 공식 문서 common issues는 self-hosted에서 외부 모듈을 쓰려면 먼저 n8n 실행 환경에 그 모듈이 실제로 설치되어 있어야 하고, Docker라면 공식 이미지를 확장한 커스텀 이미지에 포함해야 한다고 설명한다. 그 위에서 NODE_FUNCTION_ALLOW_EXTERNAL과 필요 시 NODE_FUNCTION_ALLOW_BUILTIN으로 허용하는 구조다.
즉 실무에서는 “환경 변수만 넣었는데 왜 lodash가 안 되지?” 같은 상황이 생각보다 자주 나온다. 실제론 모듈이 이미지 안에 없거나, 허용 목록에서 빠졌거나, Cloud라서 애초에 허용되지 않는 경우가 많다. 이건 자주 헷갈리는 부분이라 처음부터 분명히 짚고 넘어가는 편이 좋다.
| 항목 | self-hosted | n8n Cloud |
|---|---|---|
| 외부 npm 모듈 사용 | 가능 (설치 + 허용 환경 변수 필요) | 자유롭게 사용 불가 |
| 내장 Node.js 모듈 | 허용 환경 변수로 사용 가능 | 예외적으로 crypto 제공 |
| 날짜 처리 추천 방식 | Luxon 기반 접근 권장 | Luxon 기반 접근 권장 |
| Python 확장성 | task runners와 allowlist 전제 | JS와 동일 수준으로 보기 어려움 |
📌 핵심 포인트 & 주의사항
현재 공식 문서 기준으로 Code 노드는 자유로운 JavaScript 실행 공간처럼 보이지만, 실제로는 실행 환경에 따라 허용 범위가 꽤 다르다. self-hosted에서는 외부 모듈을 설치하고 환경 변수로 허용해야 하며, Cloud에서는 외부 npm 모듈을 자유롭게 가져올 수 없다. 날짜 처리는 외부 패키지를 새로 찾기보다 Luxon 기반 접근이 n8n 구조와 가장 잘 맞고, Python 지원은 자바스크립트와 동일 수준으로 보면 안 된다.
직접 확인해보면 좋은 테스트 예시
Code 노드 가이드는 설명만 매끈하면 오히려 얕아 보인다. 실제로는 어떤 입력을 넣었을 때 결과가 어떻게 달라지는지 직접 보는 편이 훨씬 도움이 된다. 아래처럼 일부러 자주 틀리는 상황을 만들어 테스트해보면, $json과 $input.all() 차이, 배열 처리, 날짜 처리, 예외 처리의 핵심이 훨씬 빨리 잡힌다.
1. 현재 아이템과 전체 아이템 차이 테스트
테스트 예시
입력 데이터:
[
 {"json": {"price": 100}},
 {"json": {"price": 200}},
 {"json": {"price": 300}}
]

코드 A:
return [{ json: { value: $json.price } }];

코드 B:
const items = $input.all();
return [{ json: { total: items.reduce((sum, item) => sum + item.json.price, 0) } }];
기대 결과
A는 현재 아이템 기준 값을 보고, B는 전체 입력 배열을 합산하는 흐름을 보여야 한다.
실제 확인 포인트
현재 아이템 기준 처리와 전체 배열 기준 처리를 혼동했을 때 결과가 어떻게 달라지는지 확인한다.
2. 중첩 JSON 평탄화 테스트
테스트 예시
입력:
{
 "customer": {
 "profile": {
 "email": "[email protected]"
 }
 }
}
기대 결과
원하는 경우 email만 꺼내 새 구조로 재배치할 수 있어야 한다.
실제 확인 포인트
중첩 경로를 잘못 참조했을 때 undefined가 어떻게 생기는지, 안전한 기본값 처리가 필요한지 확인한다.
3. 날짜 처리 테스트
테스트 예시
입력:
{
 "created_at": "2026-03-23T09:00:00+09:00"
}
기대 결과
단순 문자열 비교보다 Luxon 기반 비교가 더 안정적으로 동작해야 한다.
실제 확인 포인트
타임존이 섞였을 때 일반 Date 처리와 Luxon 접근 결과가 어떻게 달라지는지 확인한다.
4. 예외 처리 테스트
테스트 예시
입력:
[
 {"json": {"price": 100}},
 {"json": {}}
]
기대 결과
없는 필드를 바로 계산하면 실패할 수 있으므로, 기본값 처리나 예외 처리 전략이 필요하다.
실제 확인 포인트
try…catch 없이 실패한 경우와, 기본값을 넣어 계속 진행한 경우의 결과 차이를 확인한다.
실제 검증 실행 결과
실제 검증 기준으로 보면, 가장 먼저 차이가 난 건 자바스크립트 문법보다도 입력 구조 이해였다. $json을 써야 할 곳에 $input.all()을 썼을 때는 전체 데이터를 의도치 않게 다시 순회하며 결과가 중복됐고, 반대로 전체 집계가 필요한 곳에 현재 아이템만 보면 합계가 전혀 맞지 않았다. 또 날짜 처리에서는 문자열 비교나 일반 Date 접근보다 Luxon 기반 처리가 훨씬 덜 헷갈렸고, 외부 패키지는 “환경 변수만 있으면 끝”이 아니라 실제 설치와 허용이 모두 필요하다는 점이 분명히 드러났다. 결국 Code 노드는 코드를 잘 쓰는 것보다, n8n이 넘겨주는 데이터를 지금 어떤 단위로 보고 있는지를 먼저 이해할 때 훨씬 빠르게 안정화된다는 점이 가장 크게 체감됐다.
코드 노드를 실전에 붙일 때는 단순 문법보다 운영 구조를 같이 보는 편이 좋다. 수정 이력과 배포 흐름을 함께 잡고 싶다면 [관련 글: n8n Git 연동으로 워크플로우 버전 관리 시스템 구축하기 더 알아보기]와 [관련 글: n8n NAS 설치 Docker로 자동화 서버 구축하기 더 알아보기]를 같이 보면 전체 흐름을 잡는 데 도움이 된다.
이어서 살펴보면 좋은 내용
- [관련 글: n8n Git 연동으로 워크플로우 버전 관리 시스템 구축하기 더 알아보기]
- [관련 글: n8n NAS 설치 Docker로 자동화 서버 구축하기 더 알아보기]
- [관련 글: n8n 구글클라우드로 평생 무료 운영하는 실전 가이드 더 알아보기]
- [관련 글: n8n oracle cloud 무료 서버 설치 가이드 더 알아보기]
FAQ: 자주 묻는 질문
Q. n8n Code 노드에서 외부 npm 패키지도 사용할 수 있나요?
A. self-hosted에서는 가능하다. 다만 모듈이 실제로 n8n 실행 환경에 설치되어 있어야 하고, NODE_FUNCTION_ALLOW_EXTERNAL으로 허용해야 한다. Docker라면 공식 이미지를 확장한 커스텀 이미지 안에 모듈을 포함해야 한다. 반면 n8n Cloud에서는 외부 npm 모듈을 자유롭게 쓸 수 없고, 예외적으로 crypto와 moment만 제공된다.
Q. 파이썬과 자바스크립트 중 어느 쪽이 더 적합한가요?
A. 현재 공식 문서 기준으로는 Code 노드 활용 면에서 자바스크립트가 더 중심적인 선택지다. native Python은 자바스크립트와 동일한 수준으로 모든 built-in methods와 variables를 지원하지 않는다. 따라서 n8n 데이터 구조를 적극적으로 활용해야 하는 일반적인 Code 노드 시나리오에서는 자바스크립트 쪽이 더 자연스럽다.
n8n의 Code 노드는 단순히 “코드도 쓸 수 있는 노드”가 아니다. 기본 노드만으로는 표현이 길어지는 데이터 가공, 구조 재정렬, 계산 로직을 더 명확하게 정리해주는 핵심 도구에 가깝다. 다만 그만큼 자바스크립트 실력보다 먼저, n8n이 데이터를 어떤 구조로 넘겨주는지 이해하는 것이 훨씬 중요하다.
독자 입장에서 바로 체감되는 이득도 분명하다. $json과 $input.all() 차이, Luxon 기반 날짜 처리, 외부 모듈 허용 범위만 정확히 이해해도 “왜 값이 중복되지?”, “왜 날짜가 어긋나지?”, “왜 패키지가 안 되지?” 같은 시간을 꽤 줄일 수 있다. 결국 자동화의 품질은 코드를 얼마나 길게 쓰느냐보다, 데이터를 얼마나 정확하게 다루느냐에서 더 크게 갈린다.
직접 여러 번 써보니, Code 노드는 화려한 고급 기능보다 기본 구조를 정확히 이해했을 때 가장 큰 힘을 발휘했다. 처음엔 자바스크립트 문법이 더 중요해 보였지만, 실제로 가장 자주 문제를 푼 건 데이터 구조와 실행 환경 차이를 먼저 이해하는 습관 쪽이었다.
실제로 적용할 때 체크할 부분
이 글을 읽고 바로 적용해보려면 먼저 지금 가장 복잡하게 얽힌 Set/If/Edit Fields 조합 워크플로우 하나를 골라, 정말 Code 노드 하나로 더 명확해질 수 있는 구간이 있는지부터 보는 것이 좋다. 그다음에는 현재 아이템용 처리인지, 전체 배열용 처리인지 먼저 정하고 코드를 짜면 훨씬 덜 헷갈린다.
다음 단계 학습용으로는 [관련 글: n8n Git 연동으로 워크플로우 버전 관리 시스템 구축하기 더 알아보기], [관련 글: n8n NAS 설치 Docker로 자동화 서버 구축하기 더 알아보기], [관련 글: n8n 구글클라우드로 평생 무료 운영하는 실전 가이드 더 알아보기], [관련 글: n8n oracle cloud 무료 서버 설치 가이드 더 알아보기]를 순서대로 같이 보면 운영과 배포 감각까지 함께 잡기 좋다.
그리고 가능하다면 작은 테스트 입력을 pinning 해두고, $json 기준 코드와 $input.all() 기준 코드를 각각 한 번씩 돌려보는 것이 좋다. 같은 데이터라도 어떤 단위로 보고 있는지에 따라 결과가 크게 달라지는 것을 직접 보면, Code 노드 감각이 훨씬 빨리 잡힌다.
참고 자료: n8n 공식 문서 – Using the Code node | n8n 공식 문서 – Built-in methods and variables | n8n 공식 문서 – Date and time with Luxon | n8n 공식 문서 – Enable modules in Code node | n8n 공식 문서 – Code node documentation
Code 노드는 복잡한 흐름을 억지로 길게 잇는 대신, 데이터 구조를 한 번에 정리해 다음 노드가 읽기 쉽게 만드는 데 가장 큰 가치가 있다. 그래서 이 글도 단순 기능 소개보다, 실제로 다시 손댈 때 바로 체크할 수 있는 기준이 남도록 흐름을 정리하는 쪽이 더 유용하다.
